开发者资源
Jev Model API、价格、文档与 GitHub:开发者完整指南
一篇面向开发者的 Jev Model 指南,覆盖 API 接口、State 与类型化问题、当前价格、官方文档、GitHub 仓库以及生产环境集成清单。
Jev Model API、价格、文档与 GitHub:开发者完整指南
如果你正在搜索 Jev Model API、pricing、docs 和 GitHub,真正值得回答的问题并不只是“这个模型是什么”,而是:Jev Model 在真实软件系统里负责哪一层、API 请求长什么样、当前套餐怎么收费,以及开发者应该去哪里核对实现细节?
Jev Model 的核心工作很明确:把应用状态转换成代码可以使用的类型化决策。与其让一个大语言模型先生成一段文字,再由程序猜测下一步动作,不如直接发送 State,定义几个边界清晰的问题,然后获得结构化答案以及概率信号。你的应用可以据此路由工单、调整队列优先级、拦截高风险工具调用,或要求人工复核。
本文把开发者最关心的内容放在一起:Jev Model API 的工作方式、支持的 State 输入、Choice/Score/Noul 三种问题类型、HTTP 调用示例、当前价格、官方文档路径和公开 GitHub 组织。价格和产品权益都可能变化,下面的套餐信息是我在 2026 年 9 月 25 日核对到的快照;购买前请以当前 Jev Model 价格页为准。
目录
- 一分钟理解 Jev Model
- API 的核心模型:State、问题和结果
- 如何准备不会过载的 State
- 如何选择 Choice、Score 或 Noul
- 调用 Jev Model API
- 把概率转换成安全的业务逻辑
- Jev Model 价格:每个套餐改变了什么
- Jev Model Docs 与 GitHub:在哪里核对细节
- 生产清单与常见问题
一分钟理解 Jev Model
Jev Model 是面向软件的决策层,适合处理产品内部反复出现、答案范围相对明确的判断,而不是开放式长篇写作。常见场景包括:
- 把客服请求分类到计费、技术、账户或其他团队;
- 按有序量表评估紧急程度、严重性、满意度或运营风险;
- 判断一个即将执行的动作是否需要确认;
- 在快速模型、深度模型和人工处理之间路由任务;
- 在长时间运行的 Agent 压缩上下文时,筛选仍然重要的事实;
- 在任务进入队列前,组合意图、紧急程度和人工复核信号。
这里最重要的是职责边界:Jev 负责做判断,你的服务仍然负责权限、业务规则、阈值、工具执行、数据库写入和审计日志。Jev 返回的结果是决策信号,不应该被当成授权本身。
Jev Model 官网用一个简单的生产事故示例说明了这条链路:提供上下文,询问是否需要人工介入,然后把返回概率放进工作流代码。这样的接口接近普通函数调用,适合先验证一个判断,再逐步接入后端或 Agent。
API 的核心模型:State、问题和结果
可以把一次请求理解成三层:
state + model + questions
              ↓
类型化答案 + 概率 +(支持时返回)置信度
              ↓
你的路由、队列、安全守护或复核策略
state 是本次请求中所有问题共享的上下文,可以是一条消息、结构化 JSON 对象或一组相关文本。model 指定负责评估的模型。questions 是由稳定 ID 和具体问题组成的映射。
问题 ID 很重要,因为它会原样出现在响应里。例如请求包含 department、urgency 和 needs_human,服务端就可以用相同的字段读取结果,不需要解析一段生成式文本,也不依赖结果顺序。这是决策 API 比自由文本更容易接入控制流的关键原因之一。
Jev Model 官方开发者文档当前介绍了三种核心问题类型,并说明多个问题可以共享一份 State 并行评估。因此,一张客服工单可以在同一次请求里完成分类、评分和人工复核判断。但不要把所有业务判断都塞进一个巨大的问题。小问题更容易标注、测试、版本管理和单独修改。
如何准备不会过载的 State
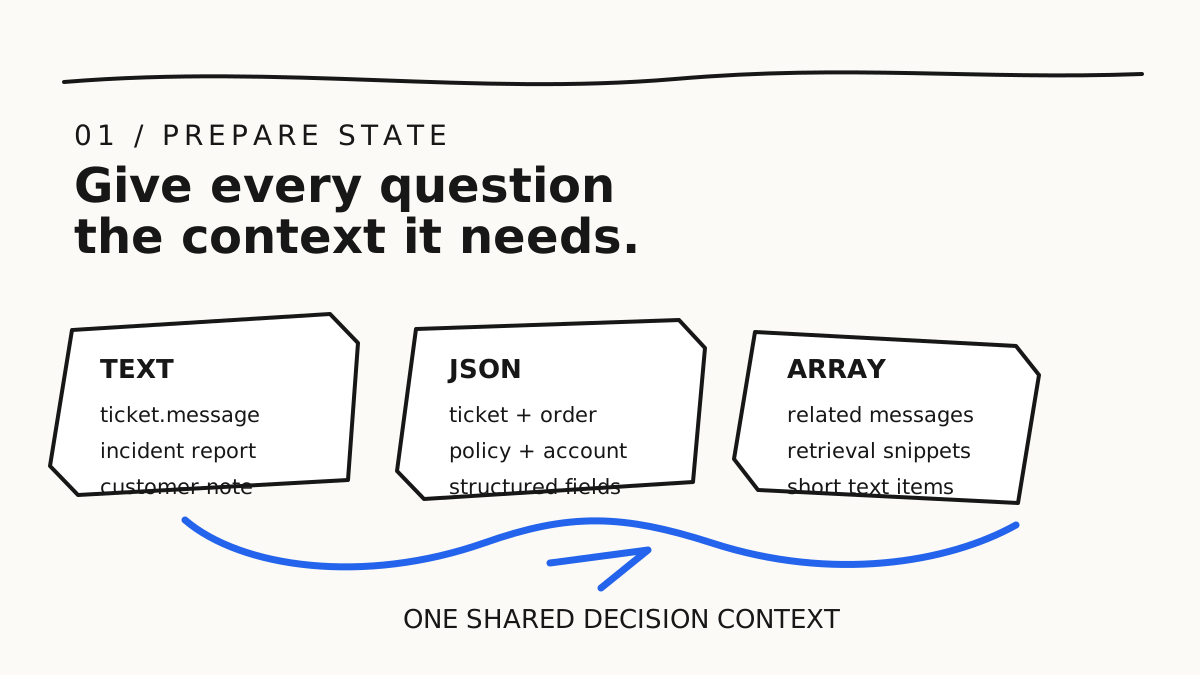
最好的 State 不是最长的 State,而是只包含当前判断真正需要的事实。应当删除密钥、无关历史和不会改变结果的个人信息。
文本 State
当判断只围绕一条消息、工单、告警或短报告时,直接传字符串最简单:
{
  "state": "Three deploys have failed and production is returning 500s."
}
文本适合第一次实验,但可能隐藏重要字段。如果判断依赖套餐、地区、政策或账户状态,最好把这些内容显式写成字段,而不是全部埋在一段话里。
JSON 对象 State
当多个字段共同影响结果时,使用对象:
{
  "state": {
    "ticket": {
      "text": "The payout has failed three times.",
      "channel": "email"
    },
    "customer": {
      "plan": "pro",
      "days_open": 3
    },
    "policy": {
      "same_day_escalation": true
    }
  }
}
对象特别适合路由和安全检查,因为问题可以引用明确的字段名,也方便编写测试样本和审计日志。但不要因此把整行数据库记录全部发送出去。只传递决策需要的数据,并在离开自己的服务前删除 Token、密码、支付信息和其他敏感值。
文本数组 State
当上下文由多条相关消息、检索片段、会话轮次或短备注组成时,可以使用文本数组。每一项都应该与当前判断有关。无关文档越多,越难解释结果为什么变化,也越容易出现意外匹配。
按照当前文档边界,Jev Model 支持文本、JSON 对象和文本数组。图片、音频和视频目前不能直接作为 State 输入。如果工作流从这些媒体开始,应先经过 OCR、转录或其他预处理,再把得到的文本或结构化字段交给 Jev。
如何选择 Choice、Score 或 Noul
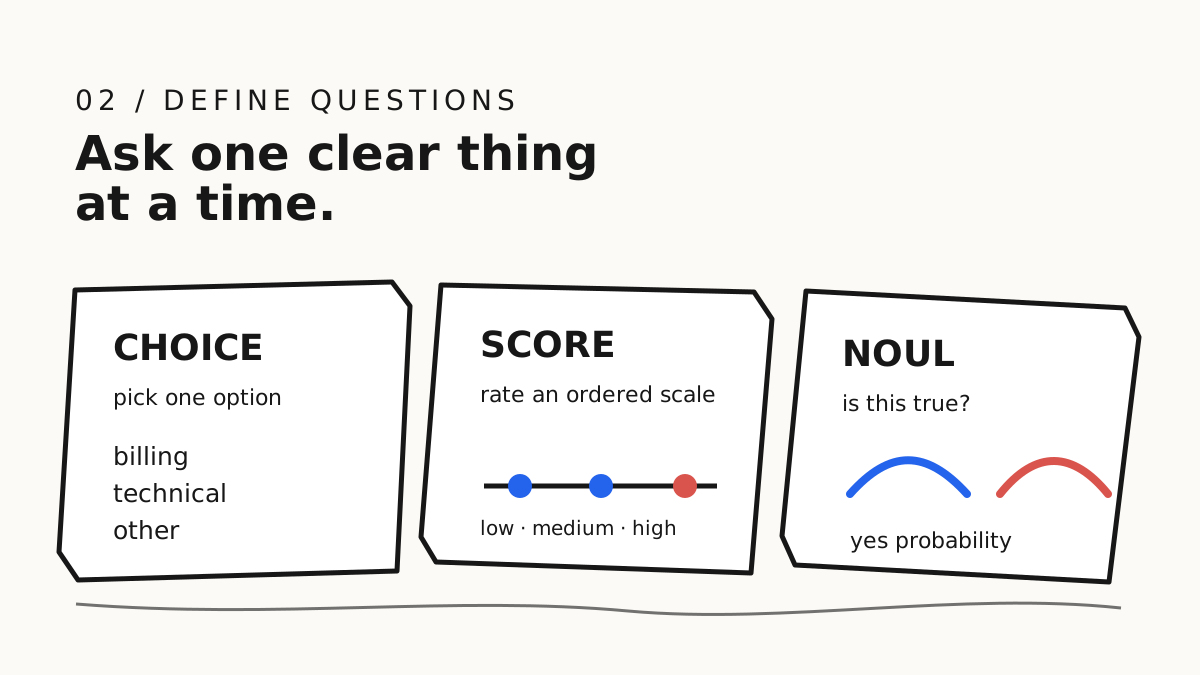
问题类型应该匹配答案的形状,而不是只看自然语言里的问法。
| 类型 | 适用场景 | 典型结果 | 示例 |
|---|---|---|---|
choice |
从已知选项中分类或路由 | 选中项、概率、置信度 | 这张工单由哪个团队处理? |
score |
有序的业务量表 | 加权分数、量表、概率、置信度 | 这次事故有多严重? |
noul |
一个是或否判断 | 答案为“是”的概率 | 这个动作是否需要人工处理? |
Choice:先定义答案空间
当应用可以提前列出结果时使用 Choice。对于客服路由,billing、technical、account、other 比 type_a、type_b 这类没有业务语义的标签更有用。如果真实世界可能超出选项集合,应加入 other、unknown 或人工复核路径,避免强迫模型选择错误答案。
Score:让每一级都能触发动作
对于低、中、高风险或紧急程度等有序量表,使用 Score。每一级都应写清楚含义以及业务会做什么。“低 / 中 / 高”如果没有定义,就不是可复用的量表。Jev 可以返回概率加权后的分数,所以分值可能落在两个命名等级之间,适合用于排序而不只是分桶。
Noul:只问一个真假问题
当问题可以改写成“这句话是否成立”时使用 Noul,例如“客户是否明确要求退款?”或“这个工具调用是否需要人工确认?”noul 值表示答案为“是”的概率,并不是另一个通用的置信度字段。阈值要根据后续动作的风险设置:普通分流和删除文件,不能使用同一套阈值。
调用 Jev Model API
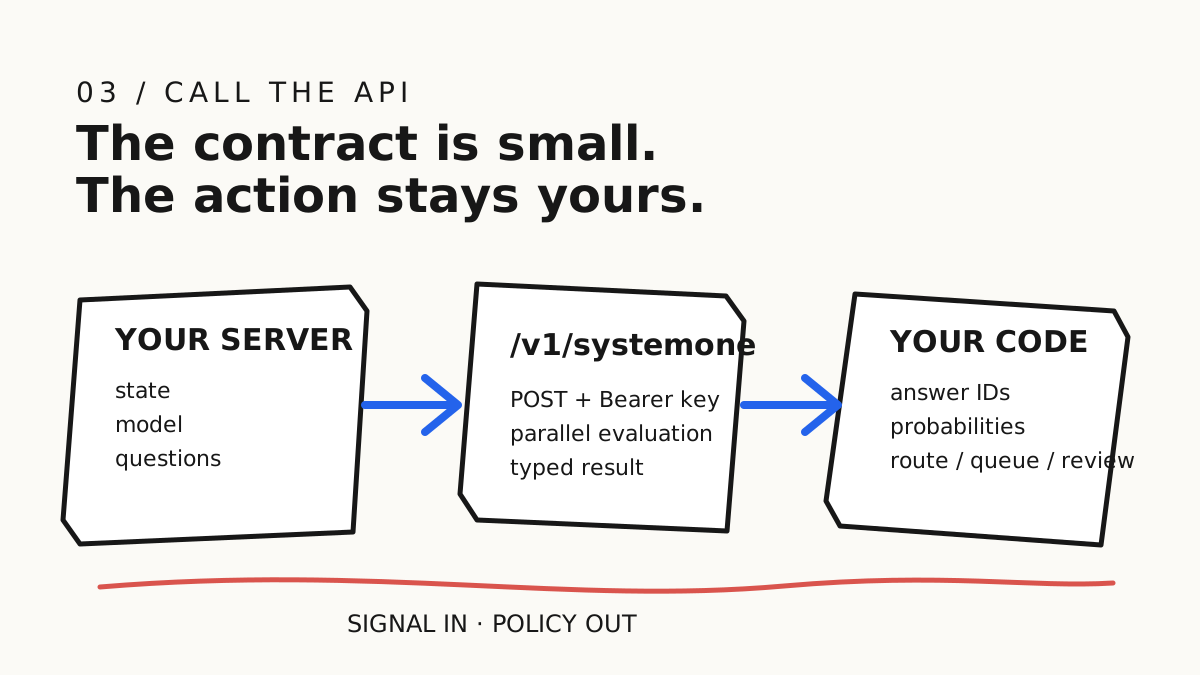
官网当前文档给出的 REST 接口是:
POST https://jevmodel.net/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
最小请求需要 state、model 和 questions 三个顶层字段。下面是一个同时完成分类、评分和人工复核判断的示例:
curl -X POST https://jevmodel.net/v1/systemone \
  -H "Authorization: Bearer $JEV_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {
      "ticket": "The customer has tried to connect Stripe for three days.",
      "plan": "pro"
    },
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Bugs, outages, and integrations",
          "account": "Login, identity, and account settings",
          "other": "No listed team is a safe match"
        }
      },
      "urgency": {
        "type": "score",
        "instructions": "How urgent is this ticket for the support queue?",
        "criteria": ["Routine", "Important", "Time-sensitive"]
      },
      "needs_human": {
        "type": "noul",
        "instructions": "Does this ticket require human review before action?"
      }
    }
  }'
这里有一个值得注意的版本问题:当前 API 参考页推荐的模型名是 jev-latest,而 Playground 和部分公开示例可能展示类似 typesafe/jev-1.13 的版本化标识。不要直接复制旧文章里的模型 ID。接入前应查看在线文档和 Playground 的 request preview。如果你更重视可复现性,可以固定版本;如果更重视自动获得更新,可以使用文档推荐的别名,并把选择写进服务配置。
API Key 必须放在服务端的环境变量或密钥管理器中,不要放进浏览器 JavaScript、公开 Markdown 中的真实示例、客户端日志或提交到 Git 的 .env 文件。生产客户端还需要配置超时、非 2xx 响应处理、请求大小限制和重试策略。
把概率转换成安全的业务逻辑
结构化响应并不等于完整工作流。服务仍然需要校验响应、执行政策,并规定模型不确定时怎么办。
概念上的响应可以是:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "probabilities": {
        "billing": 0.08,
        "technical": 0.84,
        "account": 0.05,
        "other": 0.03
      },
      "confidence": 0.75
    },
    "urgency": {
      "type": "score",
      "score": 1.7,
      "confidence": 0.78
    },
    "needs_human": {
      "type": "noul",
      "noul": 0.86
    }
  }
}
把这些数字当成信号,而不是事实保证。低风险工单路由可以使用相对宽松的阈值;支付、删除、权限或账户变更则应结合确定性授权和人工确认。要把兜底路径写清楚:未知选项进入复核队列,低置信度进入人工队列,超时使用安全默认值,响应结构错误时拒绝执行。
日志应足以帮助团队复盘,但不要记录密钥和完整敏感输入。建议记录模型 ID、问题 ID、问题版本、脱敏后的 State 摘要、概率、阈值、最终动作以及是否经过人工介入。当政策或产品行为发生变化时,重新评估问题描述和阈值,不要默认过去的边界今天仍然可靠。
Jev Model 价格:每个套餐改变了什么
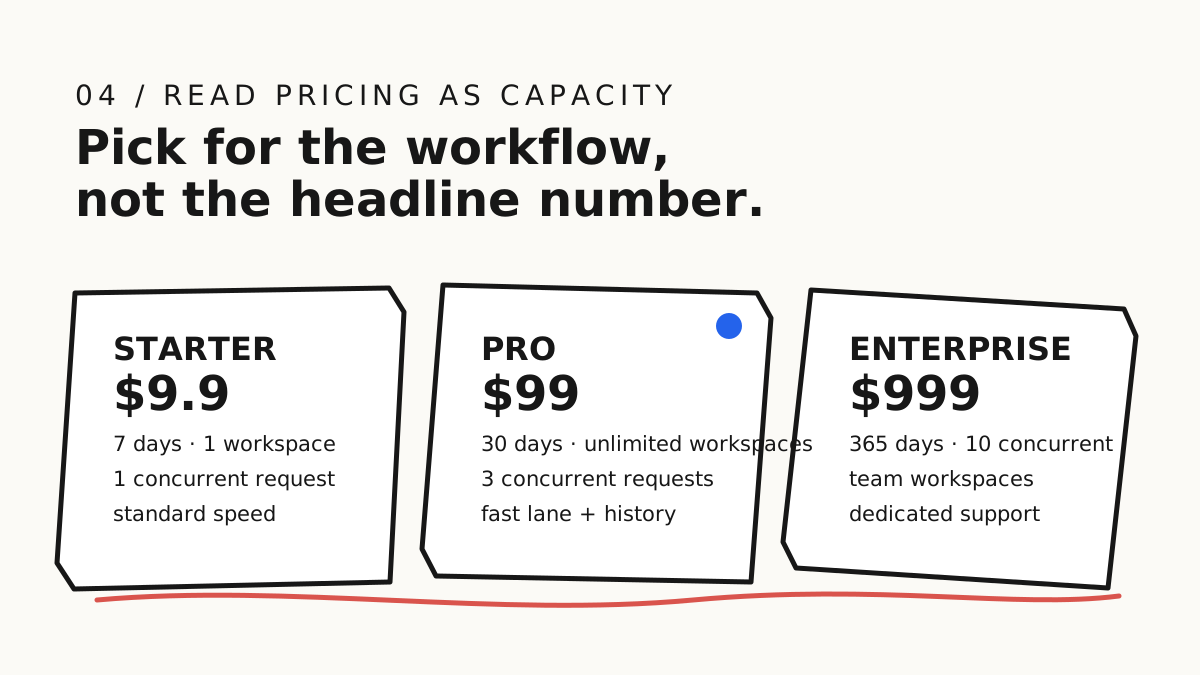
当前 Jev Model 价格页展示的是按访问周期计费的一次性方案,官网说明一次性方案在有效期内提供 unlimited usage,且不会自动续费。下面是截至 2026 年 9 月 25 日的摘要,不代表未来价格或权益不会调整。
| 套餐 | 当前价格 | 使用周期 | 容量与主要权益 |
|---|---|---|---|
| Starter | $9.9 | 7 天 | 1 个工作区、1 个并发请求、标准速度、Choice/Score/Noul、Playground、API Key 管理、邮件支持 |
| Pro | $99 | 30 天 | 无限工作区、3 个并发请求、Fast lane、并行问题、API 接入、用量与请求历史、优先支持 |
| Enterprise | $999 | 365 天 | 10 个并发请求、专属 Fast lane、团队协作、自定义集成支持、安全指导、专属与优先支持 |
三档方案都围绕类型化决策这一核心能力。实际差异主要在使用周期、工作区数量、并发容量、处理优先级以及支持方式。Starter 适合验证一个真实判断;Pro 更适合已经有多个工作区或并发生产请求的产品;Enterprise 面向长期访问、团队协作、自定义集成和更高并发。
官网首页也提供免费的在线 Playground。建议先用一个低风险案例测试输入、问题类型和响应,再决定是否购买后端接入所需的访问周期。购买前一定要重新检查价格页,因为套餐时长、并发限制、支持范围和可售状态都属于易变化的商业信息。
Jev Model Docs 与 GitHub:在哪里核对细节
应把Jev Model 官方 Docs作为请求字段、问题 criteria、响应结构、错误处理和重试行为的首要依据。可以把在线 Playground当作探索工具:输入一段有代表性的 State,定义一个小问题,运行后查看 JSON preview,再将确认过的形状写进客户端。
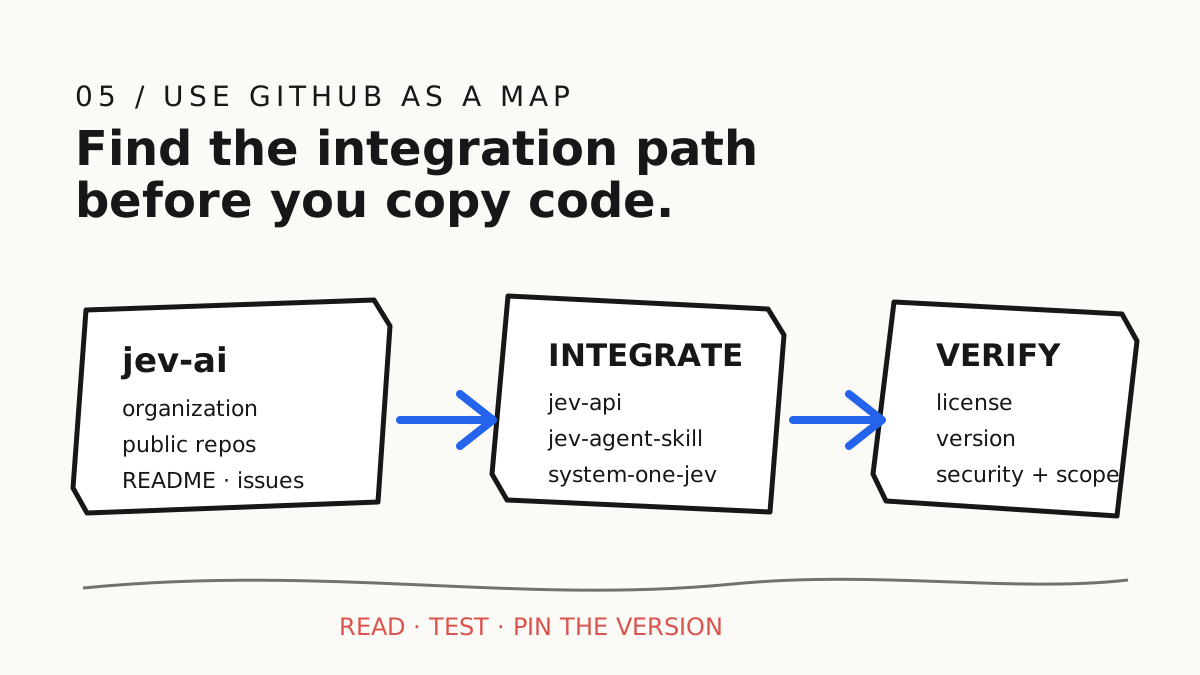
公开的 Jev AI GitHub 组织适合用来了解周边项目和集成方向。当前公开仓库列表中可以看到:
jev-api:与 API 相关的代码或示例;jev-agent-skill:让兼容的 Coding Agent 使用有边界的 Jev 决策;system-one-jev:System One 模型相关项目;jev-ai-model、typesafe-ai以及其他模型和集成仓库。
GitHub 是路线图,不是在线 API 文档的替代品。复制代码前,应检查 README、最近提交、许可证、Issue 状态、运行时要求、鉴权方式和引用的模型版本。公开仓库可能处于实验阶段、已经归档,或领先于托管 API。仓库名称本身不能保证它使用的接口或 SDK 字段仍然有效。
生产清单与常见问题
上线前清单
- 从一个低风险、可衡量的判断开始。
- 保持 State 最小化,删除密钥和无关个人数据。
- 为每个问题设置稳定 ID,并让一个问题只承担一个目的。
- 在答案空间可能不完整时加入
other、unknown或人工复核路径。 - 让 API Key 只存在于服务端密钥管理系统,并支持轮换。
- 校验状态码、响应结构、超时、重试和重复请求。
- 根据误报与漏报的成本设置阈值,不要为了方便使用统一数字。
- 把授权、确定性规则和最终动作保留在自己的服务里。
- 记录模型版本、问题版本、概率和下游动作。
- 每次生产发布或购买前重新核对文档与Jev Model 价格。
Jev Model 是聊天 API 吗?
不是。它可以放在聊天系统或 Agent 内部,但主要返回的是结构化决策。如果需要长篇解释、内容草稿或开放式对话,应使用生成式 LLM;如果应用需要代码可消费的边界信号,则适合评估 Jev Model。
一次 API 请求可以包含多个问题吗?
可以。多个问题共享一份 State,并在同一次请求中完成评估。建议保持问题彼此独立,例如把部门、紧急程度和是否需要人工处理拆成三个问题,而不是拼成一条复合指令。
Noul 和置信度是同一个东西吗?
不是。Noul 表示一个是非判断为“是”的概率;Choice 和 Score 可以返回由概率分布推导出的置信度。具体字段和类型应以当前响应文档为准,阈值则要根据下一步动作的风险制定。
应该选择 Starter、Pro 还是 Enterprise?
根据验证范围、并发量、工作区数量和支持需求选择。Starter 适合短期验证;Pro 适合需要更高容量的产品集成;Enterprise 适合更长使用周期、团队协作和自定义集成。最终购买前,务必查看实时价格页。
总结
理解 Jev Model 最简单的方式,是沿着 State → 类型化问题 → 应用动作 这条路径走一遍。API 提供一个小而清晰的契约,Docs 解释当前字段和响应,Pricing 说明可购买的访问周期与容量,GitHub 则帮助开发者发现 API、Agent Skill 和模型周边项目。无论参考哪一个仓库,线上 Docs 都是核对实时接口的首选。
如果你正在评估 Jev Model,建议先在 Playground 运行一个低风险案例,查看 request preview,再通过服务端 API Key 接入,并用历史样本和边界样本评估结果。只有当问题边界、阈值和人工兜底都被记录清楚,Jev 才能从一次演示变成可维护的路由、队列、安全守护或人工复核组件。
**资料核对日期:**2026-09-25
主要资料:Jev Model 官网、Jev Model Docs、Jev Model Playground、Jev Model 价格页、Jev AI GitHub 组织,以及相关的 Jev AI API 教程。