开发者资源
Jev Model Typesafe:类型化 AI 决策模型与开发者接入指南
了解 Jev Model 与 TypeSafe 关键词的关系,掌握 State、Choice、Score、Noul、概率输出和 Jev API 的真实使用边界。
Jev Model Typesafe:类型化 AI 决策模型与开发者接入指南
搜索 “Jev Model typesafe” 的开发者,通常想弄清楚三个问题:Jev Model 到底是什么?Playground 中出现的 typesafe/jev-1.13 与 TypeSafe 有什么关系?它和普通的大语言模型又有什么区别?
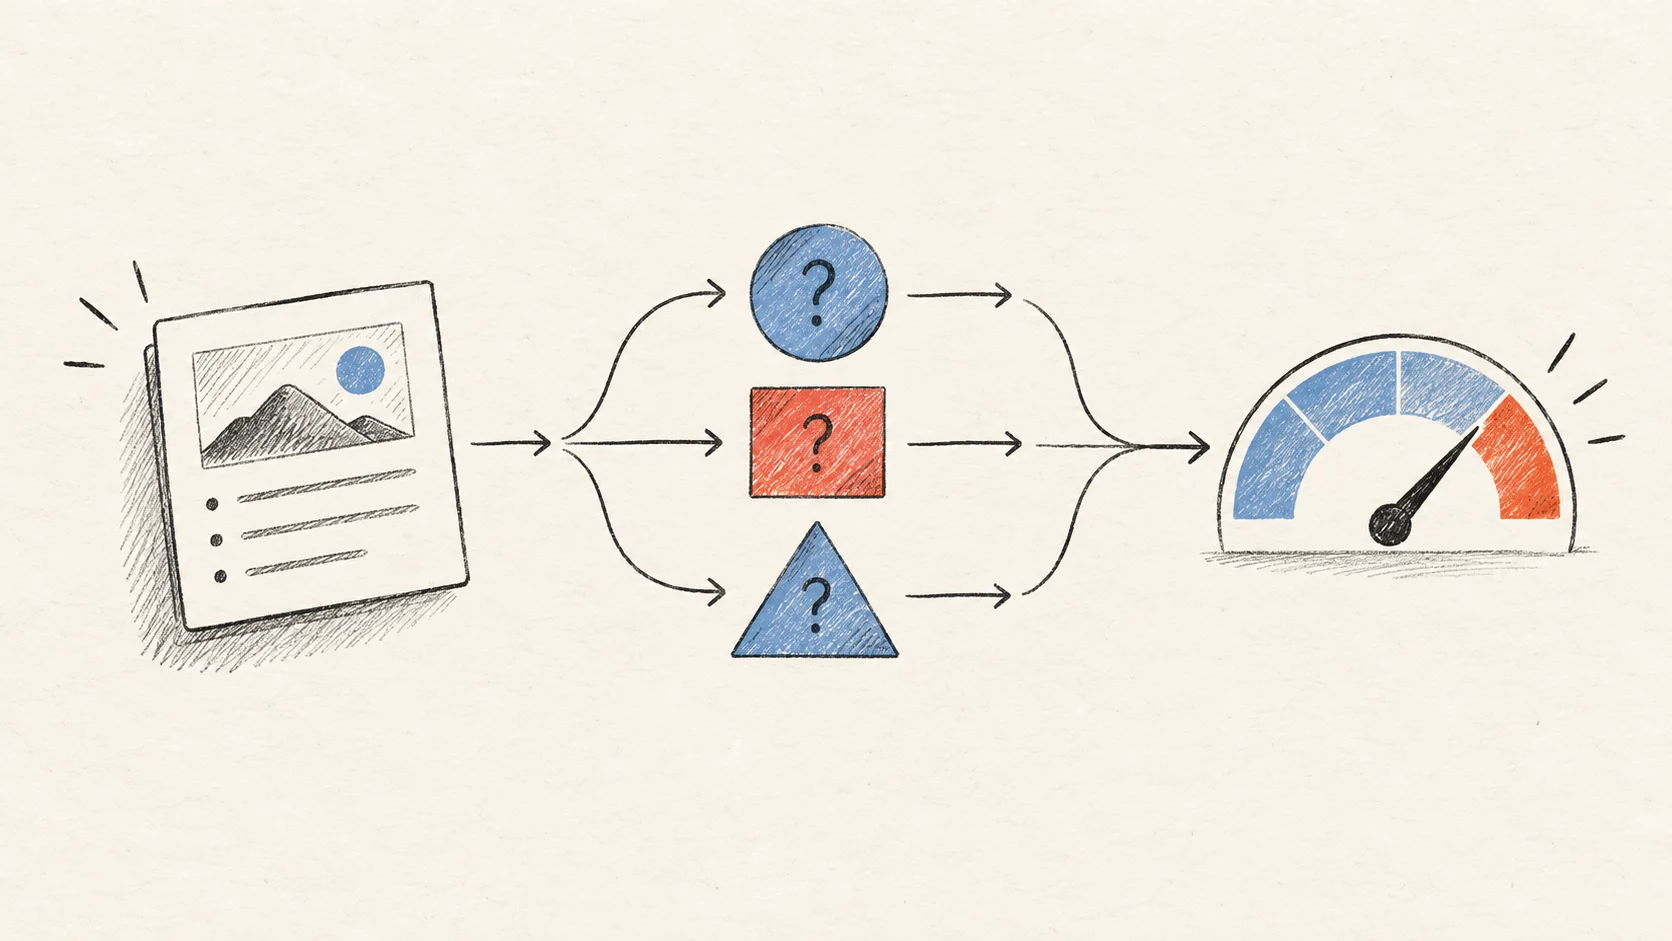
有价值的答案不只是解释一个名称,而是说明它在软件系统里承担什么工作。Jev 的产品定位不是让模型写出一段看起来合理的文字,再由业务代码去猜这段文字是什么意思;它要求你提供一份 State(状态)和一组边界清晰的问题,然后返回代码可以直接消费的类型化答案、概率以及部分问题类型对应的置信度信号。
本文从开发者实际接入的角度,解释 Jev Model 的工作方式、请求结构、三类问题类型、TypeSafe 关键词的合理理解,以及上线前必须保留的权限和人工复核边界。如果你想先看产品定位,可以阅读 Jev Model 概览;本文更关注工程实现和搜索词背后的真实意图。
目录
- 先给结论
- Jev Model 解决的是什么问题
- 类型化决策和文本生成有什么不同
- State 与 Questions:核心接口
- Choice、Score 和 Noul 怎么选
- 从 Playground 走向 Jev API
- 在工作流中如何理解 TypeSafe
- 生产环境边界与评估方法
- 哪些团队适合使用 Jev
- 常见问题
先给结论
Jev 是通过 jevmodel.net 提供的、面向软件决策的 AI 模型。它的公开接口可以概括为三个部分:
- State:包含上下文的文本、JSON 对象或文本数组。
- Typed Questions:一组具体问题,每个问题都有明确的答案类型。
- Structured Answers:与问题 key 对应的结构化答案,包括选项、分数、是的概率,以及类型支持的概率字段。
当前 Playground 中可以看到类似 typesafe/jev-1.13 的模型标识,而 API 文档使用 jev-latest 作为旗舰模型名称。这里更应该把它们理解为模型标识,而不是“Jev 是一个什么都能写的聊天机器人”。真正稳定、可复用的开发者契约是:传入上下文,预先描述答案空间,让业务代码决定下一步动作。
这个接口特别适合分类、路由、内容审核、工单分流、风险检查、销售线索评分和 Agent 安全守护。如果主要目标是写文章、聊天、生成代码、总结长文或进行开放式探索,那么生成式 LLM 仍然是更自然的选择。
Jev Model 解决的是什么问题
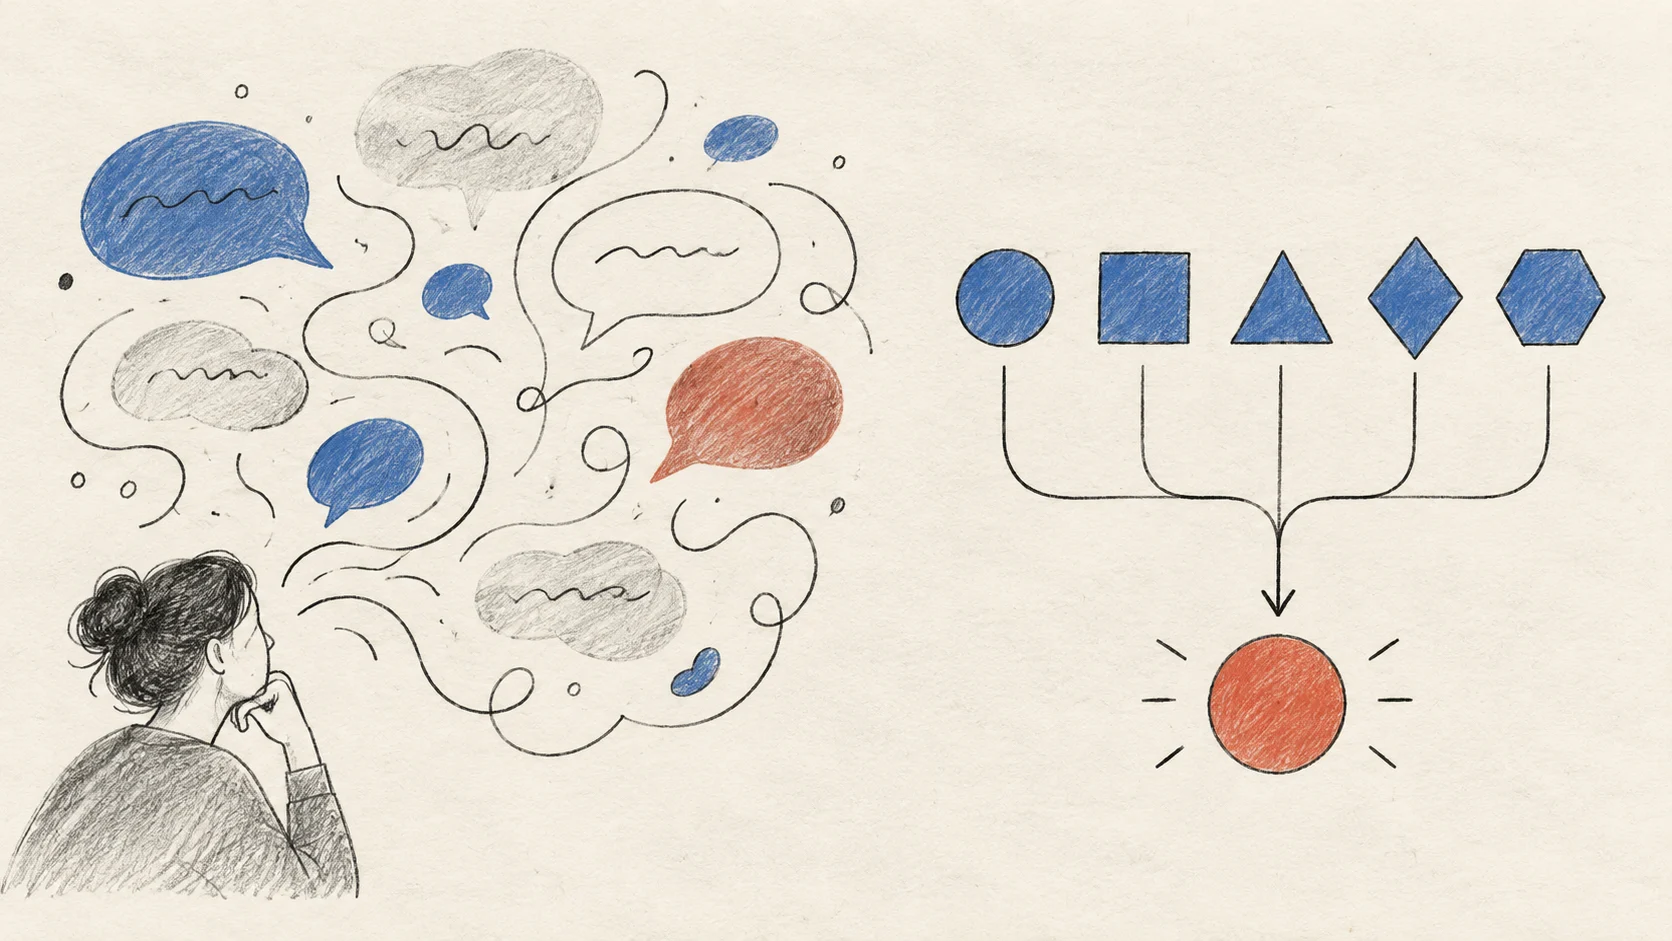
大多数语言模型 API 以 token 生成为中心。你发送指令和上下文,模型再逐 token 返回一段结果。即使要求模型输出 JSON,应用仍然需要处理选项是否越界、数字是否有效、字段是否缺失,以及解释文字是否真的对应一个安全动作。
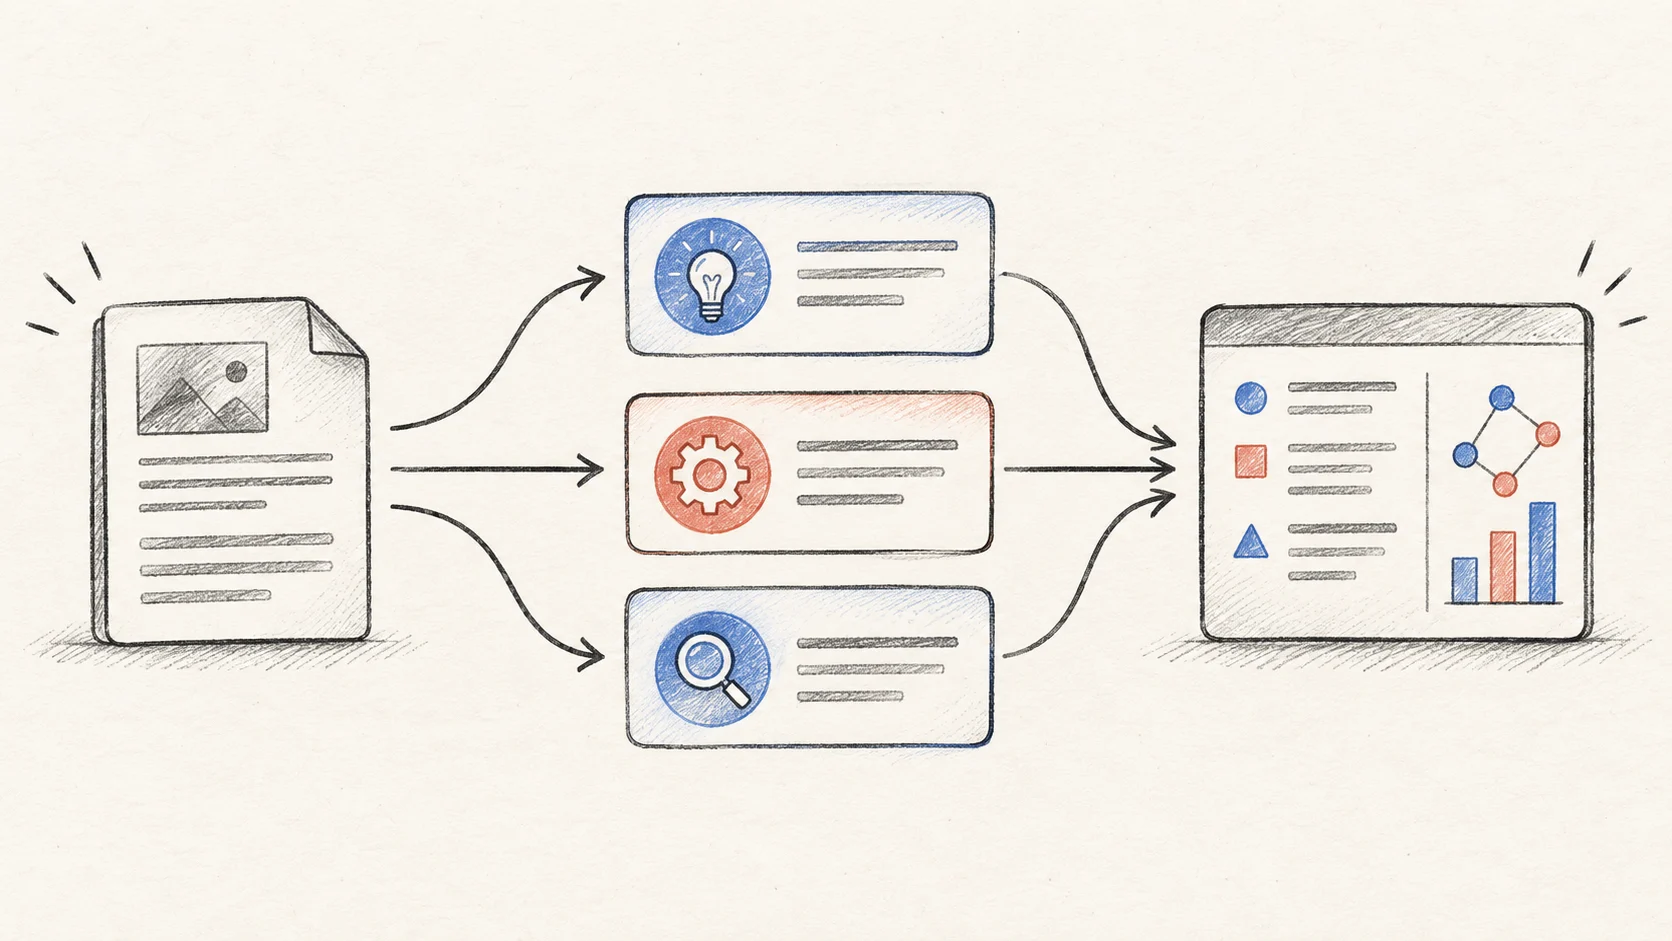
Jev 从另一个更窄、更适合软件的角度开始:程序现在需要消费哪一个边界明确的判断? 选项和评分标准在推理之前就由开发者定义,因此系统可以形成更清楚的分工:
| 层次 | 负责内容 |
|---|---|
| 业务应用 | 鉴权、组装 State、定义政策、校验输入、执行动作 |
| Jev | 根据 State 和问题返回类型化决策信号 |
| 业务应用 | 应用阈值、权限、兜底、日志和人工复核 |
这种分工不会消除模型不确定性,但会让不确定性更容易被记录和处理。Choice 可以返回每个允许选项的概率;Score 可以返回按等级加权的分数,以及各等级的概率分布;Noul 返回一个 0 到 1 之间的数,表示一个明确命题为真的概率。
因此,Jev 更像是放在现有系统中间的决策组件:可以接在解析器后面、队列前面,也可以和生成式模型并排工作,或者放进需要独立审批信号的 Agent 循环中。它不需要接管整个工作流。
类型化决策和文本生成有什么不同
例如,一张客服工单写着:“客户已经等了三天,现在要求退款。”生成式模型可以把它总结得很清楚,但队列系统最终仍然要拿到几个机器可读的字段:
- 应该由哪个团队处理?
- 紧急程度是什么?
- 是否符合退款政策?
- 是否需要交给人工?
如果直接让通用模型输出自由文本,或者输出没有边界的 JSON,应用还需要防范新标签、格式错误、缺字段,以及“听起来很自信但违反政策”的解释。使用 Jev 时,开发者先描述选项和评分标准,返回字段就能和业务代码的分支保持一致。
这并不意味着 Jev 要取代大语言模型。两者解决的是不同形状的问题:生成式模型可以起草客服回复;Jev 可以判断队列、紧急程度和复核路径;确定性的政策代码再决定退款是否真的允许。
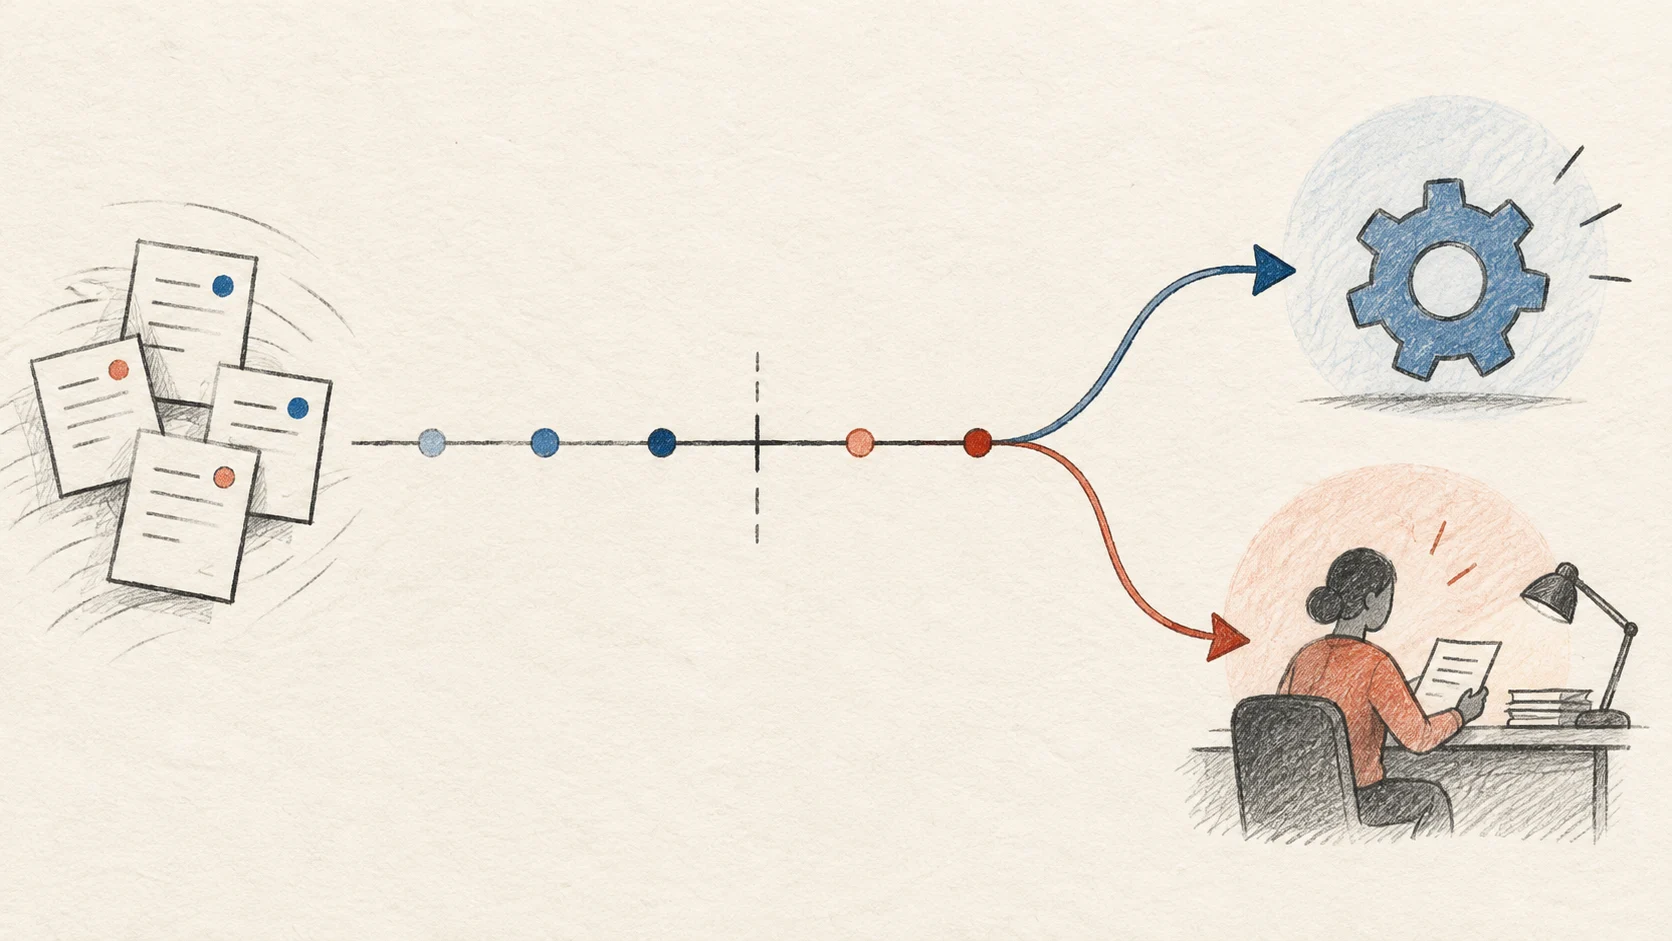
当错误决策的代价比较明确时,这个边界尤其重要。把邮件分到一个队列是一种风险;删除账户、批准付款或改变权限则是另一种风险。后者不能只依赖模型概率,概率应该被视为信号,而不是授权。
State 与 Questions:核心接口
State 是一次评估中所有问题共享的上下文。简单场景可以使用字符串;当工单、账户、政策和验证结果各自有独立含义时,使用 JSON 对象;如果上下文由多段文本组成,可以使用文本数组。当前公开文档将文本、JSON 对象和文本数组列为支持的输入边界,并没有把托管版 Jev API 定位为图像、音频或视频模型。
对业务代码来说,一个结构清楚的对象通常是最好的起点:
{
  "model": "jev-latest",
  "state": {
    "ticket_text": "客户已经等待三天,希望退款。",
    "account_tier": "pro",
    "refund_window_days": 30,
    "days_waiting": 3,
    "policy": "退款窗口内的请求可以自动进入审核。"
  },
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "这张工单应该由哪个团队处理?",
      "criteria": {
        "billing": "付款、退款、账单或扣款问题",
        "support": "产品使用或账户帮助",
        "trust": "滥用、欺诈或政策问题"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "这张工单有多紧急?",
      "criteria": ["routine", "soon", "high", "critical"]
    },
    "needs_human": {
      "type": "noul",
      "instructions": "执行动作前,这个案例是否需要人工复核?"
    }
  }
}
每个问题都应该尽量原子化。“这张工单应该怎么处理?”太宽泛,不容易测试和审计;“应该进入哪个队列?”和“是否需要人工复核?”则更容易和代码一一对应。多个问题可以共享同一个 State 并行评估,所以没有必要为了得到三个信号而连续调用三次模型。
queue、urgency 和 needs_human 这些 key 由应用自己定义,响应会沿用同样的 key。建议保持 key 稳定,这样模型版本、阈值变化和下游动作都可以在同一套事件结构中比较。
Choice、Score 和 Noul 怎么选
Choice:从允许集合中选择一个
当下一步动作属于明确集合时使用 Choice:选择处理团队、选择模型、识别意图或选择一条已批准的工作流。criteria 映射为每个选项提供语义,业务代码可以直接根据返回的 choice 分支,而不需要从段落中抽取结论。
选项之间要尽量互斥。比如“技术问题”“产品问题”和“其他技术问题”会造成重叠。更好的标签应该对应具体负责人或具体动作,并且即使模型返回了允许的值,应用代码仍然要保留兜底路径。
Score:根据有序标准评分
当答案属于有意义的低到高等级时使用 Score,例如严重程度、紧急程度、满意度或复核优先级。criteria 数组定义等级顺序,响应可以提供概率加权分数和各等级的说明。
评分标准应该和动作绑定,而不是只为了生成一个漂亮的数字。如果等级三意味着“通知值班工程师”,就应该在定义中写清楚。只有和队列、阈值或人工流程相连,Score 才会从指标变成工作流的一部分。
Noul:判断一个命题是否成立
Noul 适合具体的“是/否”判断,例如“消息是否紧急?”“这个工具调用是否需要审批?”“当前证据是否足够继续?”返回值是 0 到 1 的 yes 概率。
二元判断往往需要一个风险相关的置信度边界。低风险内部通知可能在 0.65 时继续;删除数据则可能要求 0.95、额外的政策校验和人工确认,甚至完全不自动化。阈值应该由误报和漏报的成本决定,不存在适用于所有场景的万能数字。
从 Playground 走向 Jev API
学习接口最快的方法,是先在 Jev Playground 中测试一个真实案例:填入有代表性的 State,定义一两个窄问题,然后观察完整响应,而不是只看最终标签。
问题经过验证后,再把它移到服务端。公开 API 文档中的评估端点是:
POST https://jevmodel.net/v1/systemone
请求需要 Authorization: Bearer API Key、application/json,以及 state、model 和 questions 三个顶层字段。服务端调用可以写成:
curl -X POST https://jevmodel.net/v1/systemone \
  -H "Authorization: Bearer $JEV_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "连续三次部署失败,生产环境返回 HTTP 500。",
    "questions": {
      "needs_human": {
        "type": "noul",
        "instructions": "这次故障现在是否需要人工介入?"
      }
    }
  }'
API Key 必须放在服务端环境变量中,不要写进浏览器代码、公开仓库、客户端日志或可能被记录的 Agent prompt。请求字段、响应结构、错误码和旗舰模型的当前命名,以 Jev API 文档 为准。
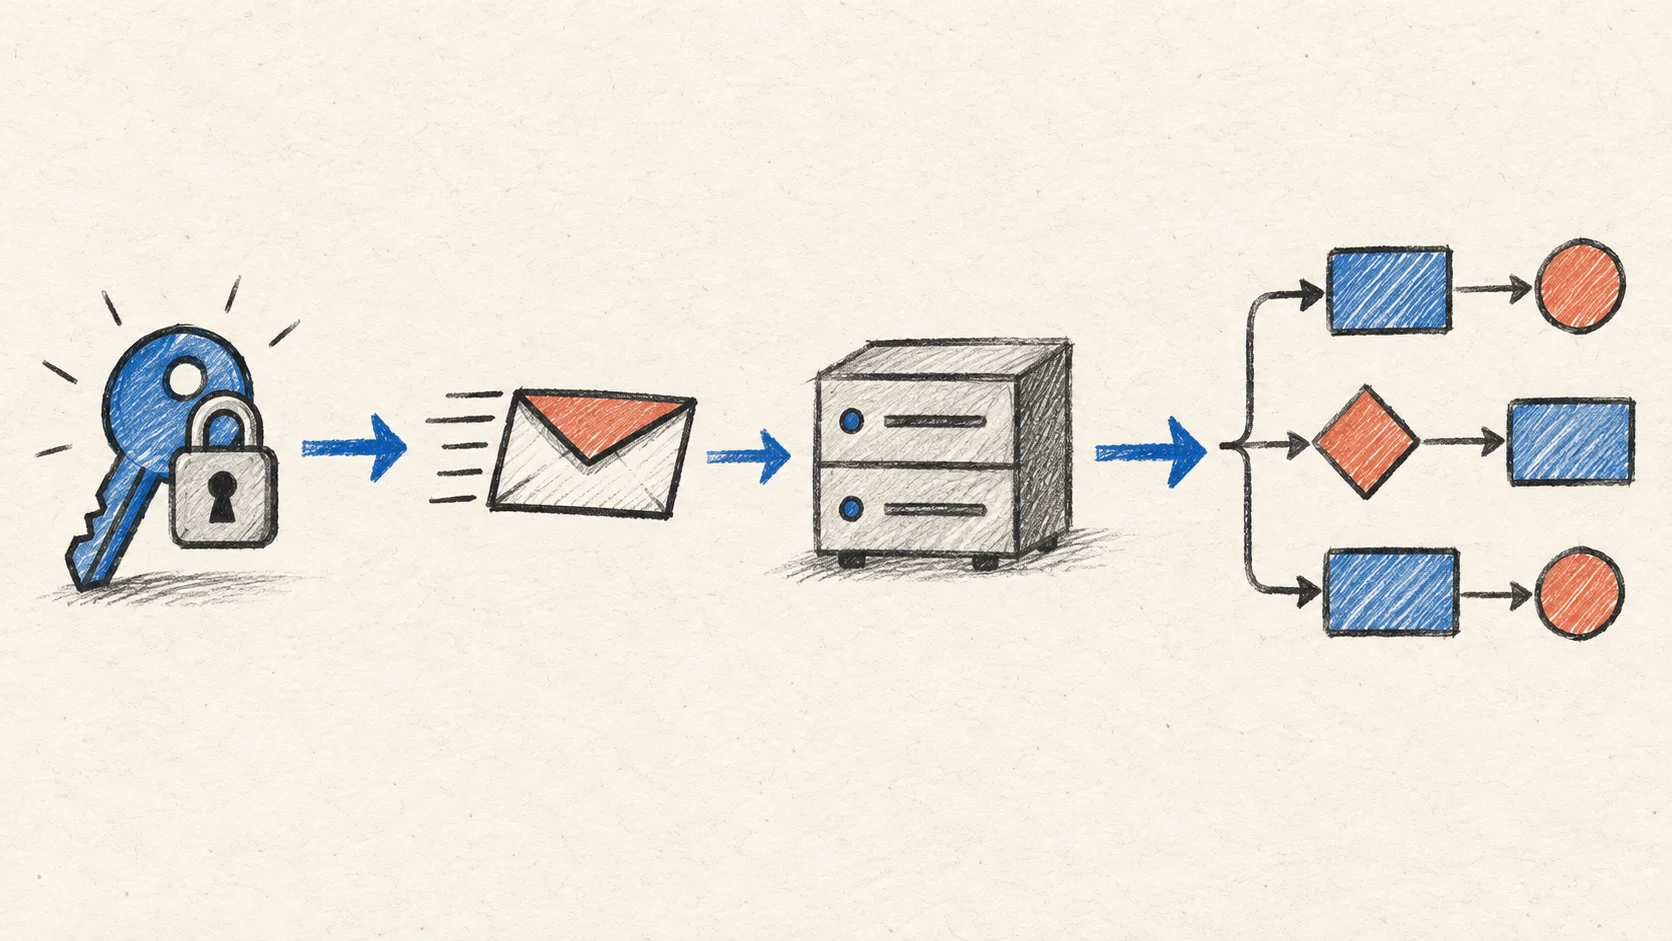
应用应该把响应当作决策函数的输入,而不是把它当成绕过系统其余部分的指令:
const answer = result.answers.needs_human;

if (answer.type !== 'noul') {
  return failClosed('Unexpected answer type');
}

if (answer.noul >= 0.8) {
  return queueForReview({ incidentId, signal: answer.noul });
}

return continueWithDeterministicChecks({ incidentId });
上线时还要加入超时、有限次数重试、请求 ID、响应校验、错误处理,以及模型不可用时的安全行为。系统拿不到判断时,不应该把“未知”悄悄转换成“允许执行”。
在工作流中如何理解 TypeSafe
“TypeSafe”容易造成误解,因为它可能指产品或公司名称、模型命名空间,也可能只是强调软件可消费的结构化输出。最稳妥的做法,是根据你实际使用的页面和接口确认信息:
- Playground 中可以看到类似
typesafe/jev-1.13的标识。 - API 文档当前使用
jev-latest作为旗舰模型名称。 - Playground、API 文档、API Key 和价格等产品入口都在 jevmodel.net 上。
- 网站页脚还保留了独立运营说明,所以不要只凭命名空间推断公司关系。涉及法务、采购、授权或对外宣传时,应以官方页面上的当前条款为准。
换句话说,“TypeSafe”是有帮助的搜索上下文,但对开发者最重要的是类型化决策接口。工程上应记录你使用的模型标识,保存请求和响应示例,并在模型或评分标准变更后重新跑一套评估集。
生产环境边界与评估方法
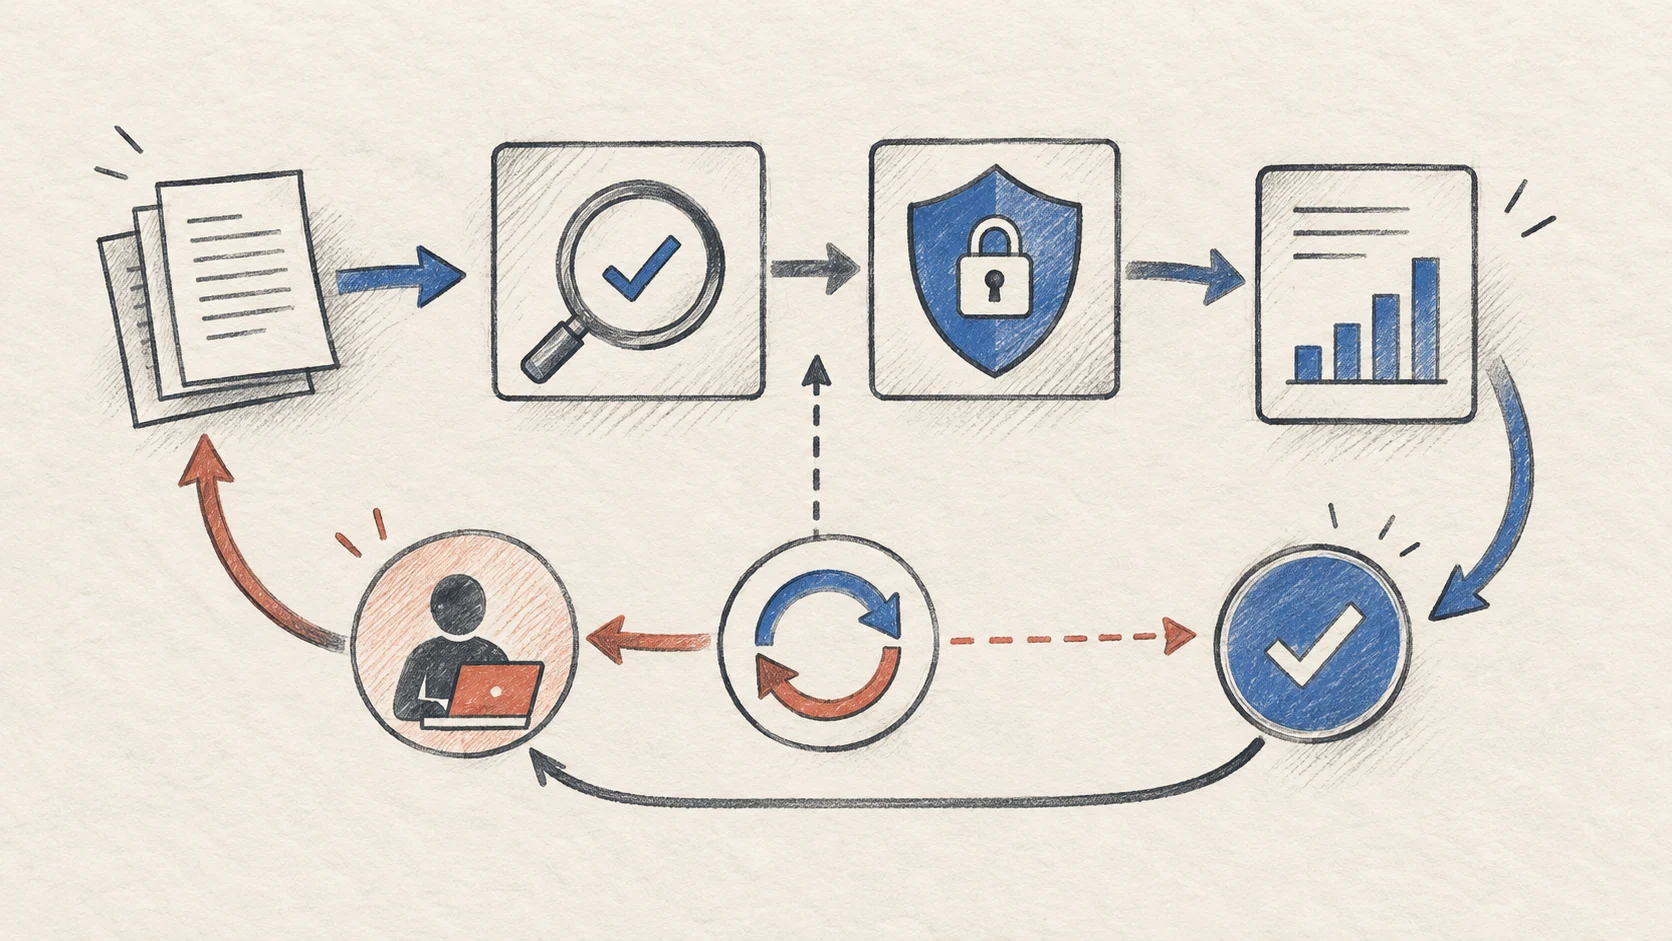
一个强健的 Jev 集成通常从一个小决策开始:它有历史样本、有明确标签,也有可以量化的后续动作。在调阈值之前先建立评估集,包含普通案例、边界案例、缺失字段、对抗性措辞、需要支持的多语言输入,以及人工本身存在分歧的样本。
至少需要跟踪四类指标:
- 决策质量:把选项或分数和可信的人工标签对比。
- 概率校准:检查概率为 0.8 的样本,在目标切片中是否真的接近 80% 的命中率。
- 业务结果:观察队列等待时间、人工复核量、误升级率或避免的事故数。
- 故障兜底:确认超时、不支持的输入和无效响应都会安全失败。
不同风险必须使用不同阈值。低影响的内容标签可以用较低置信度自动路由;付款、删除、封禁、权限变更和安全动作则应叠加确定性政策校验,通常还要保留人工审批。模型置信度不等于业务准确率,更不等于授权。
State 也要保持最小化和有目的。删除密钥、不必要的个人信息和无关历史,只保留完成判断所需要的字段。可以加入问题需要的政策或评分标准,但没有必要把整套业务数据库复制给模型。
最后,日志需要足够支持复现:模型标识、问题版本、State schema 版本、返回答案、概率、阈值、最终动作,以及人工是否修改了结果。API Key 和敏感载荷要脱敏,并在上线前设定保留周期。
哪些团队适合使用 Jev
当以下条件大部分成立时,Jev 值得优先评估:
- 决策有有限且可描述的答案空间;
- 相同判断会以足够高的频率重复发生;
- 结果需要被程序直接消费;
- 每个选项或评分等级都能写出清楚的含义;
- 你可以测量结果,或者至少定期抽样复核。
合适的起点包括客服工单分流、销售线索筛选、内容审核信号、模型路由、工具调用守护、文档分类,以及 Agent 工作流中的“是否需要人工处理”判断。
如果任务需要写作、总结、对话、解释、生成代码或开放式探索,则应该使用生成式模型,或者把它和 Jev 组合起来。Jev 可以判断一份草稿是否满足条件,也可以决定请求应该路由到哪条路径,但它不是所有 AI 能力的替代品。
如果你想进一步理解 Jev 与传统 LLM 的职责边界,可以先看 Jev Model 官网首页,再通过 Jev 定价页面确认当前访问方案;请求和响应字段仍应以前文链接的 API 文档为准。
常见问题
Jev Model 和普通 LLM 是同一种模型吗?
不是。普通 LLM 通常逐 token 生成文本;Jev 的公开定位是面向决策的模型:开发者定义类型化问题,模型返回应用可以直接使用的结构化答案。
typesafe/jev-1.13 是什么意思?
它是当前 Playground 中出现的模型标识。API 文档使用 jev-latest 作为旗舰 API 模型名。接入时应以自己实际使用的页面或接口为准,并为模型版本变化保留评估和回滚能力。
Jev 会返回概率吗?
会。Choice 可以返回每个选项的概率,Score 可以返回每个等级的概率和加权分数,Noul 返回 0 到 1 的 yes 概率。但这些值是决策信号,不是准确率保证。
Jev 能直接处理图像和音频吗?
当前公开 API 文档描述的输入是文本、JSON 对象和文本数组,没有把图像、音频或视频列为托管 Jev API 的输入类型。如果判断依赖媒体,应先使用合适的多模态系统提取必要信息,再把结构化 State 交给决策步骤。
Jev 能替代业务权限系统吗?
不能。应用仍然必须完成鉴权、权限判断、工具名和参数校验、政策执行,并决定是否真正执行。模型答案不应该成为唯一的授权层。
第一个 Jev 用例应该怎么选?
选择一个低风险、高频、有明确标签和可量化结果的判断。先在 Playground 验证,再把最小请求接到 API,最后补齐阈值、日志和人工复核,再逐步扩大范围。