开发者资源
Jev System One 模型:类型化 AI 决策的实用指南
了解 Jev System One 模型如何处理 State 与类型化 Questions,如何通过 API 返回带概率的结构化决策,并把结果接入生产软件和 AI Agent。
很多 AI 产品围绕“生成”设计:写一段回复、总结文档、制定计划或生成代码。但软件团队还需要另一种能力:重复做出清晰的小判断。例如,这张工单应该进入哪个队列?这个工具调用是否有风险?当前请求是否需要人工介入?证据是否足够支持发布?
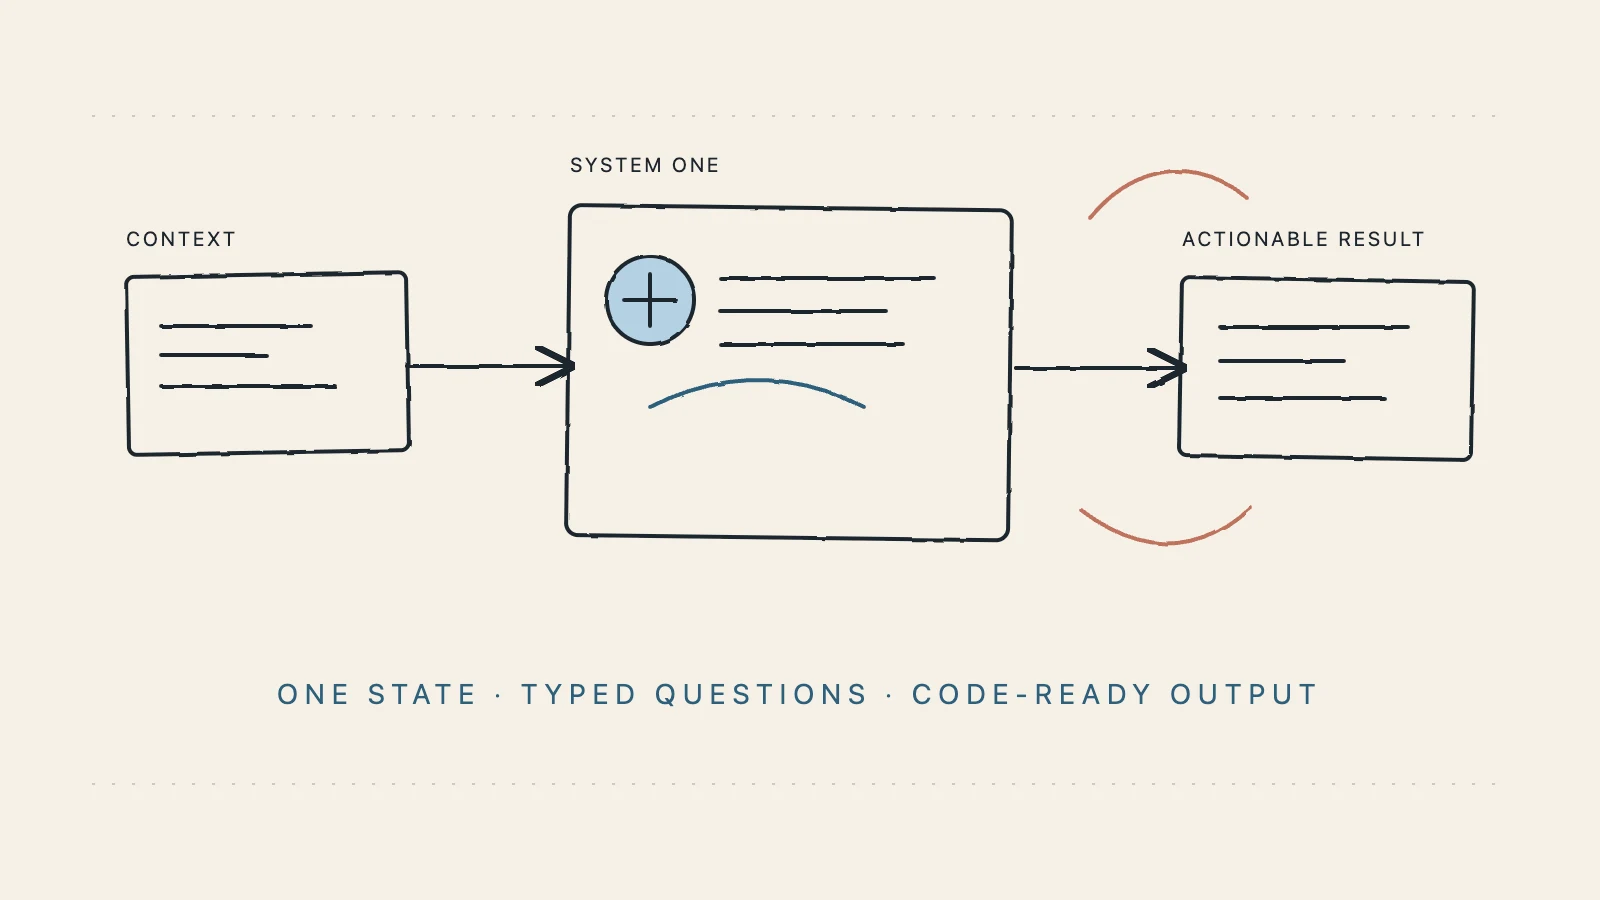
这正是 jev system one model 要解决的问题。你不需要让一个开放式模型先写一段话,再从自然语言里猜测结论。相反,你可以发送一份 State 和一组类型化 Questions,让 Jev 返回应用代码可以校验、记录、设置阈值并接入控制流的结构化 Answers。
本文会从工程实践角度解释 Jev System One 模型:System One 的定位、请求结构、三种问题类型、API 接入、概率与置信度、生产环境边界,以及 Jev 和生成式 LLM 的分工。重点不是给每个步骤都增加一次 AI 调用,而是把原本已经存在于产品里的判断做成一个清晰、可测试的决策边界。
目录
- System One 在软件中的含义
- 为什么应用需要决策模型
- Jev System One 模型如何工作
- 三种类型化问题
- 如何设计有用的 State
- 最小 API 请求
- 完整的客服分流示例
- 概率、置信度与阈值
- 让 Jev 与 LLM 和 Agent 协作
- 生产环境检查清单
- 边界、评估与常见错误
- 常见问题
System One 在软件中的含义
在 Jev 的产品语境里,System One 是一个面向软件的专注型决策层。它不是应用、权限系统、工作流引擎或生成式模型的替代品。它接收一份定义清楚的 State,评估边界清晰的问题,再返回可以交给代码使用的类型化信号。
把生成和决策分开很有价值,因为它们的失败方式不同。一个生成式模型可能非常擅长起草客服回复,但不一定适合直接承载严格的分流政策。自由文本可以用很多种方式表达“这看起来很紧急”;类型化结果则可以明确返回 is_urgent 字段、概率和应用知道如何处理的路径。
可以先记住下面这个模型:
state + typed questions → Jev System One → structured answers → 应用动作
最终动作仍然由应用负责。如果 Jev 判断一张工单很可能紧急,你的代码可以选择通知值班工程师、移动队列、继续收集证据,或把案件交给人工。这样的边界对于审计、安全和后续调优都很重要。
想了解当前输入和输出字段,可以先阅读 Jev Model 官方文档。它适合核对最新的请求字段、问题类型和响应结构。
为什么应用需要决策模型
很多产品流程本来就包含大量隐藏判断,只是它们可能被写成一串 Prompt、正则表达式、硬编码分支或人工队列:
- 把客服请求分到 billing、technical、account 或 sales;
- 判断 Agent 准备执行的动作应该允许、确认还是拒绝;
- 在销售队列前给 Lead 分级;
- 标记需要审核的内容;
- 判断长对话应该压缩、保留还是重新请求上下文;
- 为一个任务选择快速模型、深度模型、检索流程或兜底路径。
这些判断通常有三个特征:答案空间有限;多个问题共享同一份上下文;结果需要进入代码,而不是停留在聊天记录里。
Jev System One 适合这样的结构。你可以明确写出应用关心的问题,为每种类型提供标准,最后拿到稳定的答案形状,再用普通代码接住结果:
if (answer.needs_human.noul >= 0.8) {
  await queueForReview(ticket.id);
}
这并不意味着结果自动正确,而是让决策边界变得可见、可测试、可改进。团队可以统计某个阈值把多少请求送入人工审核,拿模型结果与标注数据对照,并调整政策,而不必重写一整套开放式对话 Prompt。
Jev System One 模型如何工作
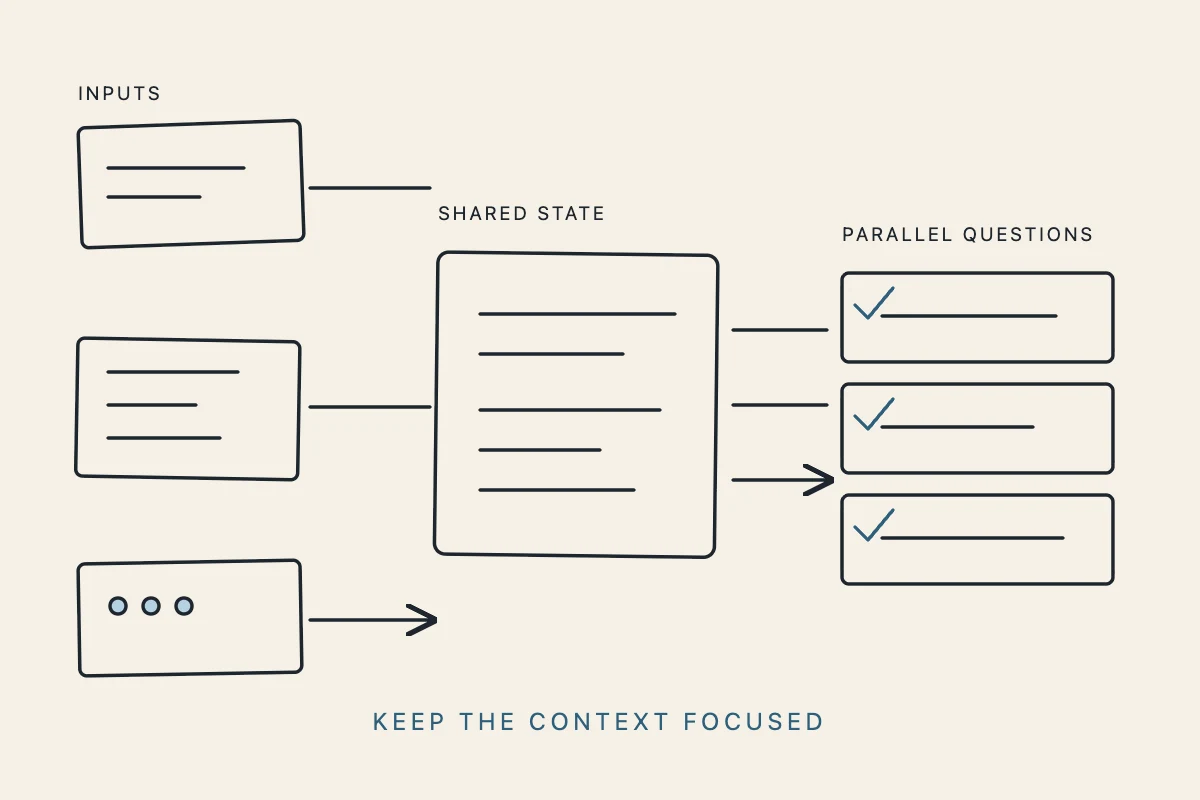
它可以拆成三个概念层:State、Questions 和 Answers。
1. State 是共享上下文
State 是每个问题都会读取的内容。简单消息可以用字符串;结构化记录可以用 JSON 对象;多个自然语言片段则可以用文本数组。客服流程可以把工单、用户等级、近期事件和业务政策作为一个对象发送。
好的 State 应该聚焦。只放回答问题需要的证据,不要在只需要几个字段时把整条数据库记录或完整 Agent 对话全部发过去。输入更聚焦,判断就更容易解释,也更不容易意外依赖无关字段。
2. Questions 定义答案空间
每个问题都应该只问一件具体的事。问题 key 由应用选择,并会原样出现在响应中。比如 team、severity 和 needs_human 就比“请决定这个请求该怎么办”更容易接入代码。
多个问题可以共享同一个 State 并行评估。如果一次请求既需要分流、严重度和人工审核信号,就不必为了拆开结果连续发三次请求。
3. Answers 返回类型化信号
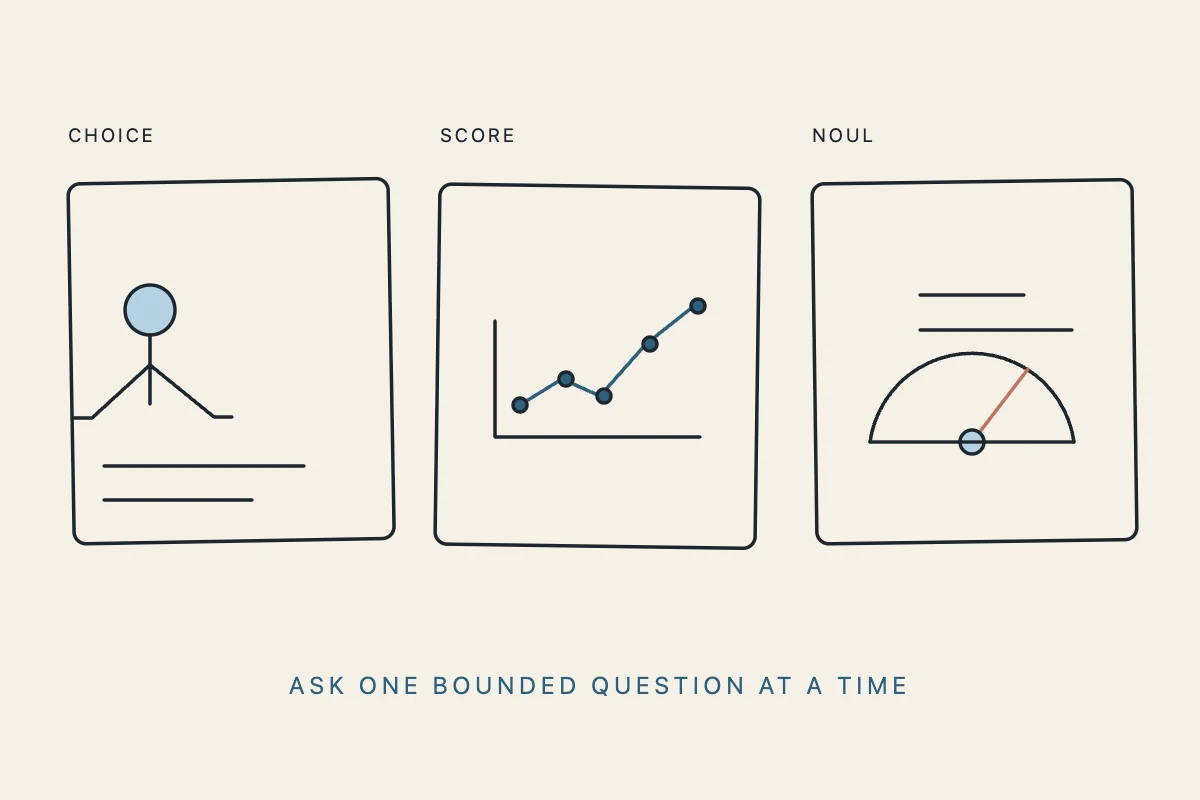
响应会使用请求中的问题 ID。Choice 会返回选中的选项、概率分布和置信度;Score 会返回加权分数、等级说明、每一级的概率和置信度;Noul 会返回 0 到 1 之间的数值,代表某个命题为真的概率。
虽然返回结果是结构化的,但应用仍应校验实际依赖的字段,按风险设置阈值,并为高影响动作保留人工审核路径。
三种类型化问题
Choice:分类或路由
当结果必须从预定义选项中选择一个时,使用 choice。它适合团队分流、模型选择、内容标签或已批准的工作流路径。criteria 对象会把每个选项映射到描述,让模型看到的不只是几个没有解释的标签。
{
  "team": {
    "type": "choice",
    "instructions": "应该由哪个已批准的团队处理?",
    "criteria": {
      "billing": "付款、发票、退款或扣款问题",
      "technical": "产品故障或集成问题",
      "account": "登录、个人资料或工作区权限问题",
      "sales": "购买咨询或企业评估"
    }
  }
}
当每个选项都能对应到明确的下一步动作时,Choice 最容易落地。
Score:评估有序等级
当答案处于一个从低到高的连续尺度上时,使用 score,例如低到严重的影响程度、平静到非常沮丧的情绪,或早期到成熟的购买意向。criteria 是从低到高排列的数组。返回的分数可能落在两个等级之间,因为它是概率加权结果,所以更适合用作政策信号,而不是绝对标签。
{
  "severity": {
    "type": "score",
    "instructions": "这个问题对客户的影响有多严重?",
    "criteria": [
      "仅供参考,没有用户影响",
      "影响有限,有临时解决方法",
      "影响较大,核心流程被阻断",
      "严重或关键,可能涉及大范围或安全风险"
    ]
  }
}
Noul:判断一个命题是否为真
当你需要判断一个聚焦的“是/否”命题时,使用 noul。返回值介于 0 到 1,0 表示否,1 表示是。Noul 应该描述一个具体命题,而不是要求模型生成一份完整计划。
{
  "needs_human": {
    "type": "noul",
    "instructions": "这个拟执行动作是否需要人工批准?",
    "criteria": {
      "true": "动作敏感、具有破坏性、不可逆或证据不足",
      "false": "动作可逆、符合政策且证据充分"
    }
  }
}
Noul 适合安全闸门、证据检查、升级判断和任务完成度验证。但它不授予权限,只是为你的政策提供一个可以计算的信号。
如何设计有用的 State
好的 Jev 接入从输入设计开始,而不是从 SDK 调用开始。先想清楚决策真正需要看到什么。
客服工单可以使用这样的 State:
{
  "ticket": {
    "subject": "Payouts have failed for three days",
    "message": "我今天尝试了两次,仍然无法提现。",
    "account_tier": "pro",
    "recent_events": ["payout_failed", "payout_failed", "payout_failed"]
  },
  "policy": {
    "critical_keywords": ["fraud", "locked", "data loss"],
    "human_review_required_for": ["关闭账户", "超过 1000 的退款"]
  }
}
相比直接发送完整的用户记录,这种对象更好,因为每个字段都能解释为什么存在,也更便于构建标注案例、修改一条证据并观察结果是否按预期变化。
设计时可以遵循下面的原则:
- State 放证据,不要藏指令。 把政策放在显式字段中,让问题明确说明要判断什么。
- 问题保持原子化。 “应该由哪个团队处理?”与“是否需要人工?”是两个问题。
- criteria 要能指导动作。 说明标签在工作流里意味着什么,不要只解释词语表面含义。
- 删除无关上下文。 无关字段会让判断更难解释,也更难定位回归问题。
- 版本化决策契约。 把 State 结构、问题 ID、criteria 和阈值政策放进版本控制。
当前文档里的输入边界是文本、JSON 对象和文本数组,暂不支持直接用图片、音频和视频作为 State。若流程从其他模态开始,可以先加一个独立的提取步骤,并单独评估提取质量。
最小 API 请求
在 Jev Model Playground 里验证一个判断之后,再把它从服务端接入产品。当前评估端点是:
POST https://jevmodel.net/v1/systemone
请求使用 Bearer API Key 和 application/json。最小示例:
curl -X POST https://jevmodel.net/v1/systemone \
  -H "Authorization: Bearer $JEV_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "我的提现已经失败三天了。",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "这条消息是否表达了紧急性?"
      }
    }
  }'
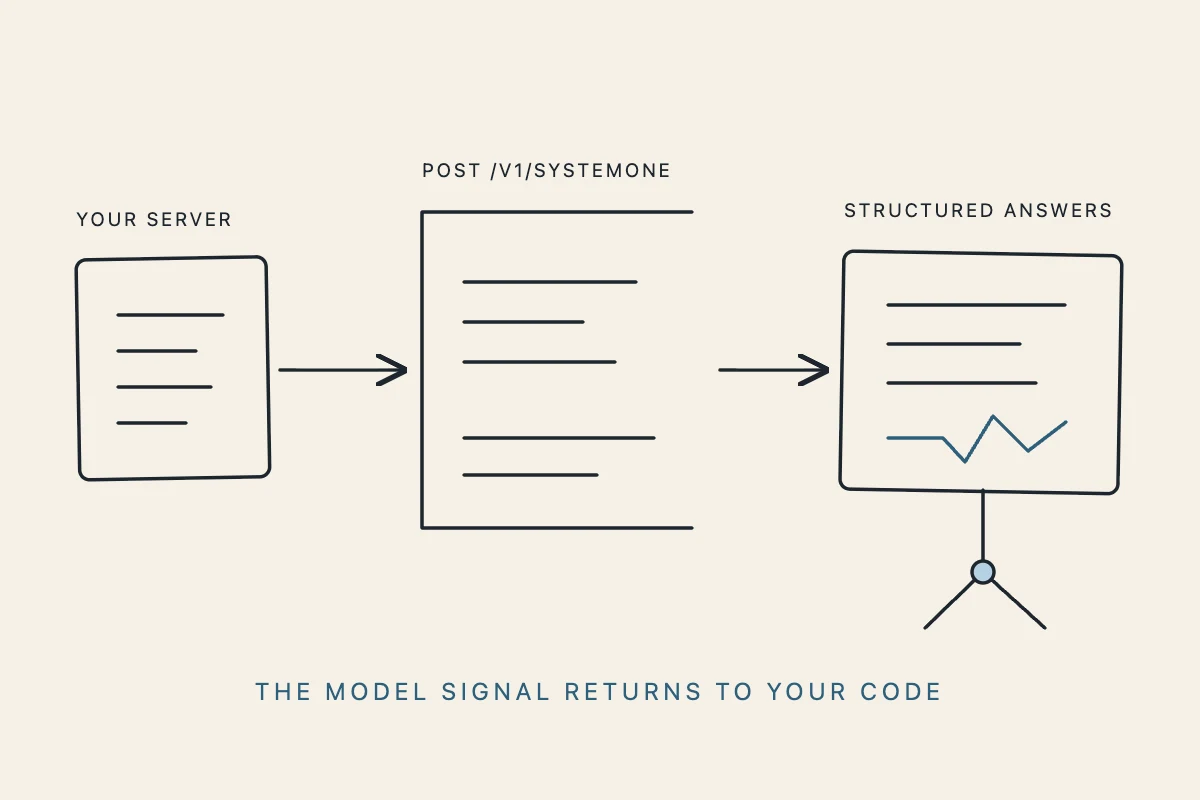
顶层最重要的字段是 state、model 和 questions。当前 API 文档使用 jev-latest 作为旗舰模型名。API Key 必须保存在服务端环境变量里,不能放在浏览器代码、客户端 Bundle、公开 Prompt、日志或提交到仓库的文件中。
典型响应可以通过问题 ID 读取:
{
  "model": "jev-1.13.0",
  "answers": {
    "is_urgent": {
      "type": "noul",
      "noul": 0.95
    }
  },
  "usage": {
    "input_tokens": 307,
    "output_tokens": 20
  }
}
响应还可能包含本次请求耗时。Usage 字段适合做监控和成本分析,Answers 字段则进入应用的决策分支。
完整的客服分流示例
假设客服服务要完成三件事:确定处理团队、估计严重程度、判断是否需要人工复核。三个问题可以共享一份 State:
{
  "model": "jev-latest",
  "state": {
    "subject": "Payouts have failed for three days",
    "message": "I tried twice today and cannot withdraw funds.",
    "customer_tier": "pro",
    "recent_events": ["payout_failed", "payout_failed", "payout_failed"],
    "policy": "Escalate repeated payment failures and any fraud signal."
  },
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "哪个已批准的团队应该处理这张工单?",
      "criteria": {
        "billing": "付款、发票、退款或扣款",
        "technical": "产品或集成故障",
        "account": "访问、身份或工作区问题",
        "sales": "购买或套餐评估问题"
      }
    },
    "severity": {
      "type": "score",
      "instructions": "客户受到的影响有多严重?",
      "criteria": ["low", "medium", "high", "critical"]
    },
    "needs_human": {
      "type": "noul",
      "instructions": "下一步动作前是否需要人工复核?"
    }
  }
}
应用服务可以用确定性的方式接住结果:
const team = result.answers.team.choice;
const severity = result.answers.severity.score;
const humanProbability = result.answers.needs_human.noul;

if (humanProbability >= 0.8 || severity >= 2.5) {
  return queueForHumanReview({ ticketId, team, result });
}

return routeToTeam({ ticketId, team, priority: severity });
真实代码还需要加上选项白名单、Schema 校验、幂等、鉴权和审计日志。无论模型返回的批准概率多高,它都不应该成为退款、删除、付款、账户变更或外部消息的唯一保护措施。
概率、置信度与阈值
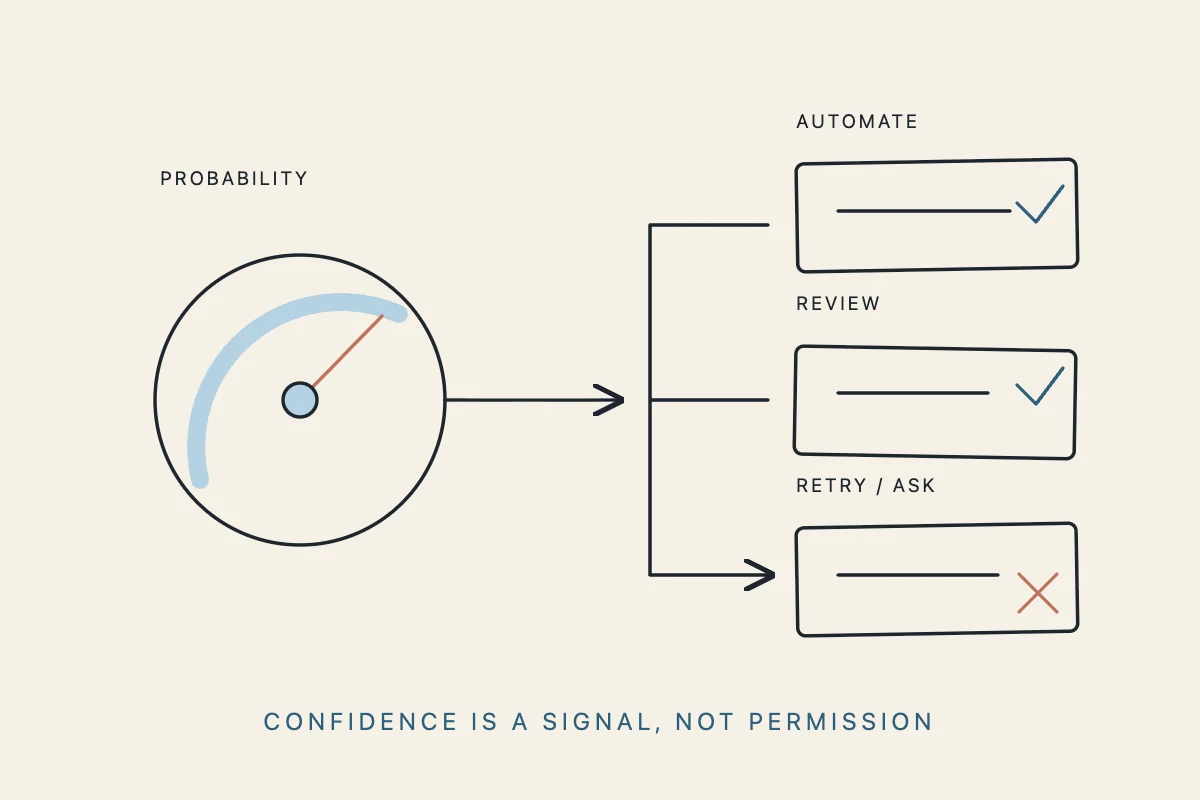
概率的价值在于,它能表达不确定性,而不是把所有判断压缩成一个硬标签。但概率也很容易被误用。它不是你业务准确率的保证,置信度也不等同于在真实数据上的成功率。
相比只设一个自动通过阈值,建议先采用三段式策略:
- 高信号: 只有在动作低风险且结果超过已经测试的阈值时才自动继续。
- 中间信号: 请求更多上下文、按受控策略重试,或进入人工审核。
- 低信号: 对不支持、不安全或违反政策的动作停止或拒绝。
阈值取决于错误成本。对于内部内容标签,0.65 可能适合早期实验;对于不可逆的账户动作,则可能需要更高阈值、确定性的权限校验和明确的用户确认。不要因为两个字段都叫 confidence 就直接复用别的工作流阈值。
用有代表性的数据集评估阈值。至少记录假阳性、假阴性、人工审核率、延迟,以及每种错误给业务带来的成本。当你修改 State 结构、criteria 文案、模型或下游政策时,都应该重新评估。
让 Jev 与 LLM 和 Agent 协作
Jev 和生成式 LLM 适合 AI 系统中的不同环节。LLM 可以理解宽泛请求、起草回复、总结证据或提出计划;Jev 则适合针对有限答案空间做一个边界清晰的判断;最终哪些动作被允许,仍然由应用代码决定。
一个使用 Jev 的 AI Agent 流程可以这样组织:
- Agent 读取用户请求并提出下一步动作。
- 应用构建一份聚焦的 State,包含拟调用工具、参数、权限、政策和证据。
- Jev 针对路由、风险、完成度或证据回答 Choice、Score 或 Noul 问题。
- 确定性代码再检查授权、资源范围、幂等性和阈值。
- 应用执行动作、请求确认,或把任务送入人工审核。
这样的分工可以避免 Agent 把一个看似合理的计划静默地变成已授权动作。Jev 可以判断“这个工具调用是否需要批准”,但它不能替代权限系统。凭证和执行权仍然属于宿主应用。
同样的边界也适合模型路由。生成式模型可以提出一个请求是否简单,但类型化 Choice 可以在一个小型白名单中选择模型,最终服务仍然负责强制执行白名单、预算和数据政策。
如果你要把判断接入 Agent,可以继续阅读 Jev AI API 教程,里面介绍了如何缩小 API 请求、解读返回类型,并将答案接入应用控制流。
生产环境检查清单
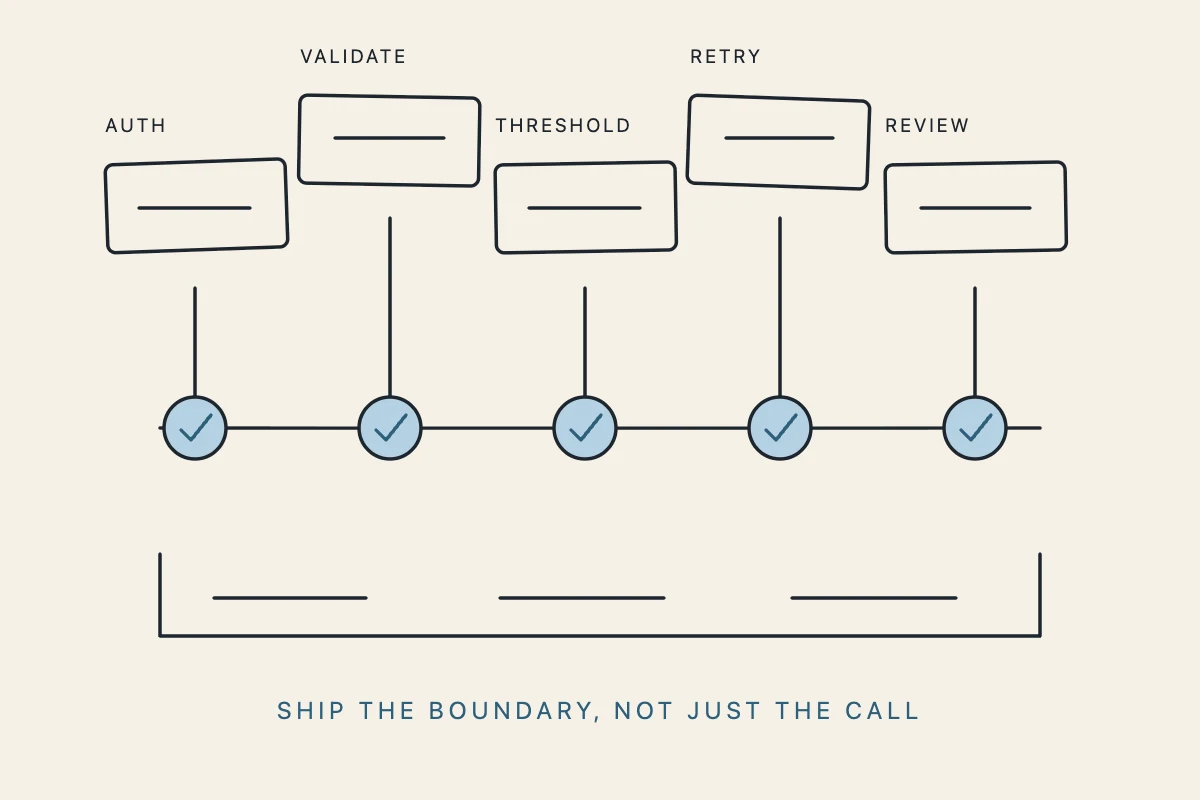
把一个 Jev System One 判断放进线上工作流前,可以逐层检查:
契约
- State 范围明确,并且结构有版本号。
- 问题 ID 稳定、易读。
- Choice 的 criteria 之间边界清楚。
- Score 的等级按照从低到高排序。
- Noul 指令只描述一个命题。
安全
- API Key 只作为服务端密钥保存,不进入浏览器变量。
- 动作执行前由应用完成鉴权。
- 根据数据政策最小化或脱敏敏感字段。
- 破坏性动作要求确认或人工审核。
可靠性
- 使用 Schema 校验响应后再进入业务分支。
- 设置超时和有上限的重试次数。
- 401 触发凭证检查,422 触发请求体修复。
- 429 和 529 使用指数退避,避免立即重复请求。
- 用幂等保护下游动作,避免重复执行。
可观测性
- 记录契约版本、问题 ID、答案、概率、阈值和最终动作。
- 保留解释审核结论所需的证据,但不要无必要存储个人信息。
- 监控延迟、Token 用量、错误率、自动化率和审核率。
- 定期抽样进行人工质量复核。
评估
- 准备包含模糊案例和对抗案例的代表性样本。
- 按问题类型和类别分别评估。
- 将自动结果与标注结果对照。
- 当业务成本或政策变化时重新检查阈值。
如果需要估算下一阶段的工作区、并发和使用周期,可以查看 Jev pricing 页面。
边界、评估与常见错误
第一个常见错误是把开放问题设计成“请告诉我该怎么办”。这类结果难以强制执行。更好的方式是问“哪个已批准的路径适用:billing、technical、account 还是 sales?”,让模型和应用共享同一个契约。
第二个错误是把高概率当成权限。概率只能帮助政策做决定,不能替代授权、输入校验和人工判断。
第三个错误是发送过多上下文。更长的输入不一定意味着更多证据。无关历史可能引入隐藏依赖,让回归测试变得难以诊断。
第四个错误是跳过 Playground。一次低风险的人工测试,往往就能发现 State 缺了关键字段、两个 criteria 重叠,或者一个问题其实混合了两个判断。先在 Jev Model Playground 验证真实案例,再把它自动化。
第五个错误是默认所有模态都可用。当前文档里的输入边界是文本、JSON 对象和文本数组。如果产品从图片、录音或视频开始,请先加入独立提取步骤,并单独评估提取质量。
不要只追求最短的 Prompt,而要追求半年后另一位工程师仍能理解的决策。写清楚问题、定义 criteria、说明政策、保持结果结构化,并记录应用最终做了什么。
常见问题
Jev System One 是另一个通用 LLM 吗?
更准确的理解是:它是一个面向软件的决策模型和 API 层。它可以理解 State 并回答问题,但核心价值在于让代码能消费类型化、边界清晰的结果,而不是生成很长的对话文本。
什么时候使用 Choice,什么时候使用 Noul?
需要从白名单中选一个结果时用 Choice;需要判断一个命题为真的概率时用 Noul,例如“这个动作是否需要批准”或“这张工单是否表达紧急性”。
多个问题可以共用一次请求吗?
可以。多个问题可以针对同一份 State 并行评估,适合同时获得路由、评分和人工审核信号。
置信度等于准确率吗?
不等于。置信度描述模型对某个答案分布的确定程度,准确率必须使用你自己业务里的代表性标注数据测量。高影响系统即使得到高置信度,也应该保留人工审核路径。
Jev 会执行我的工具或 Agent 动作吗?
不会。Jev 返回决策信号,应用、Agent 宿主、权限和确定性政策仍然负责决定动作是否真的可以执行。
总结
当产品里的 Prompt、队列或条件分支中已经藏着一个判断时,jev system one model 最有价值。给它聚焦的 State,提出类型化问题,读取结构化 Answers,再把最终动作留在应用代码里。先从一个低风险判断开始,用真实案例评估,再逐步扩展到路由、队列、安全闸门或 Agent 工作流。
这样,AI 就不再只是一个输出段落的黑盒,而会成为软件系统里一个小型、可检查的组件:它可以分类、评分、路由、升级,也可以在不夺走业务控制权的前提下提醒系统寻求帮助。